ELITE 深读:3D 数据先验与单步扩散如何协作生成 Gaussian 头像
Mechanism And Evidence Deep Read
这篇文章不把 ELITE 写成“又一个更强 talking-head 模型”的摘要,而是把它拆回一个更可审计的问题:为什么 3D data prior 负责把几何与可驱动性拉回稳定区,2D generative prior 负责把身份细节和覆盖度补回来,而两者的协作能在 20 min 级别个性化里真正成立。
问题与结论
ELITE 讨论的不是“如何从大量多视角采集里离线训练一个头部 avatar”,而是更苛刻的单目视频个性化问题:给定一段普通 monocular source video,能否较快得到一个可驱动、身份稳定、视角泛化尚可的 Gaussian head avatar。这里最稀缺的资源不是算力,而是监督覆盖度。真实视频只看到有限表情和有限视角,直接用这些帧优化,通常会在几何、身份或细节中至少丢一个。
ELITE 的回答是把监督拆成两层。第一层是 3D data prior:先学一个从 canonical FLAME UV 表达直接落到 2D Gaussian 参数图的 initialization network,让个性化一开始就站在“可驱动、可渲染”的区域。第二层是 2D generative prior:在 test time 针对当前 subject 生成额外、但更像本人的 novel-view / novel-expression 监督,专门补原视频没覆盖到的姿态与表情。
论文卡片
题目:ELITE: Efficient Gaussian Head Avatar from a Monocular Video via Learned Initialization and TEst-time Generative Adaptation
作者:Kim Youwang, Lee Hyoseok, Park Subin, Gerard Pons-Moll, Tae-Hyun Oh
版本边界:本文正文机制主要来自 arXiv v1(2026-01-15)的官方 HTML/PDF;项目页标注为 CVPR 2026,二者不应混写成同一证据层级。
这篇 paper 最值得深读的地方,是它把 personalization bottleneck 说得很具体:不是模型“不够大”,而是只靠少量真实帧进行 subject-specific adaptation 时,几何、身份与细节共享同一组稀缺监督。ELITE 通过 learned initialization 和 generative adaptation,把这三种责任拆开处理。
先验协作假设
论文把已有路线概括成四类:只做 test-time optimization 的方法,重 3D prior 的方法,重 2D generative prior 的方法,以及像 ELITE 这样同时调用两类先验的方法。这个分类并不是综述式罗列,而是在为“为何需要双先验”搭台。只靠 3D data prior,结构往往更稳,但细节和身份纹理可能不够锐;只靠 2D generative prior,则容易得到好看的图,却未必能稳定蒸馏回一个可驱动 3D avatar。
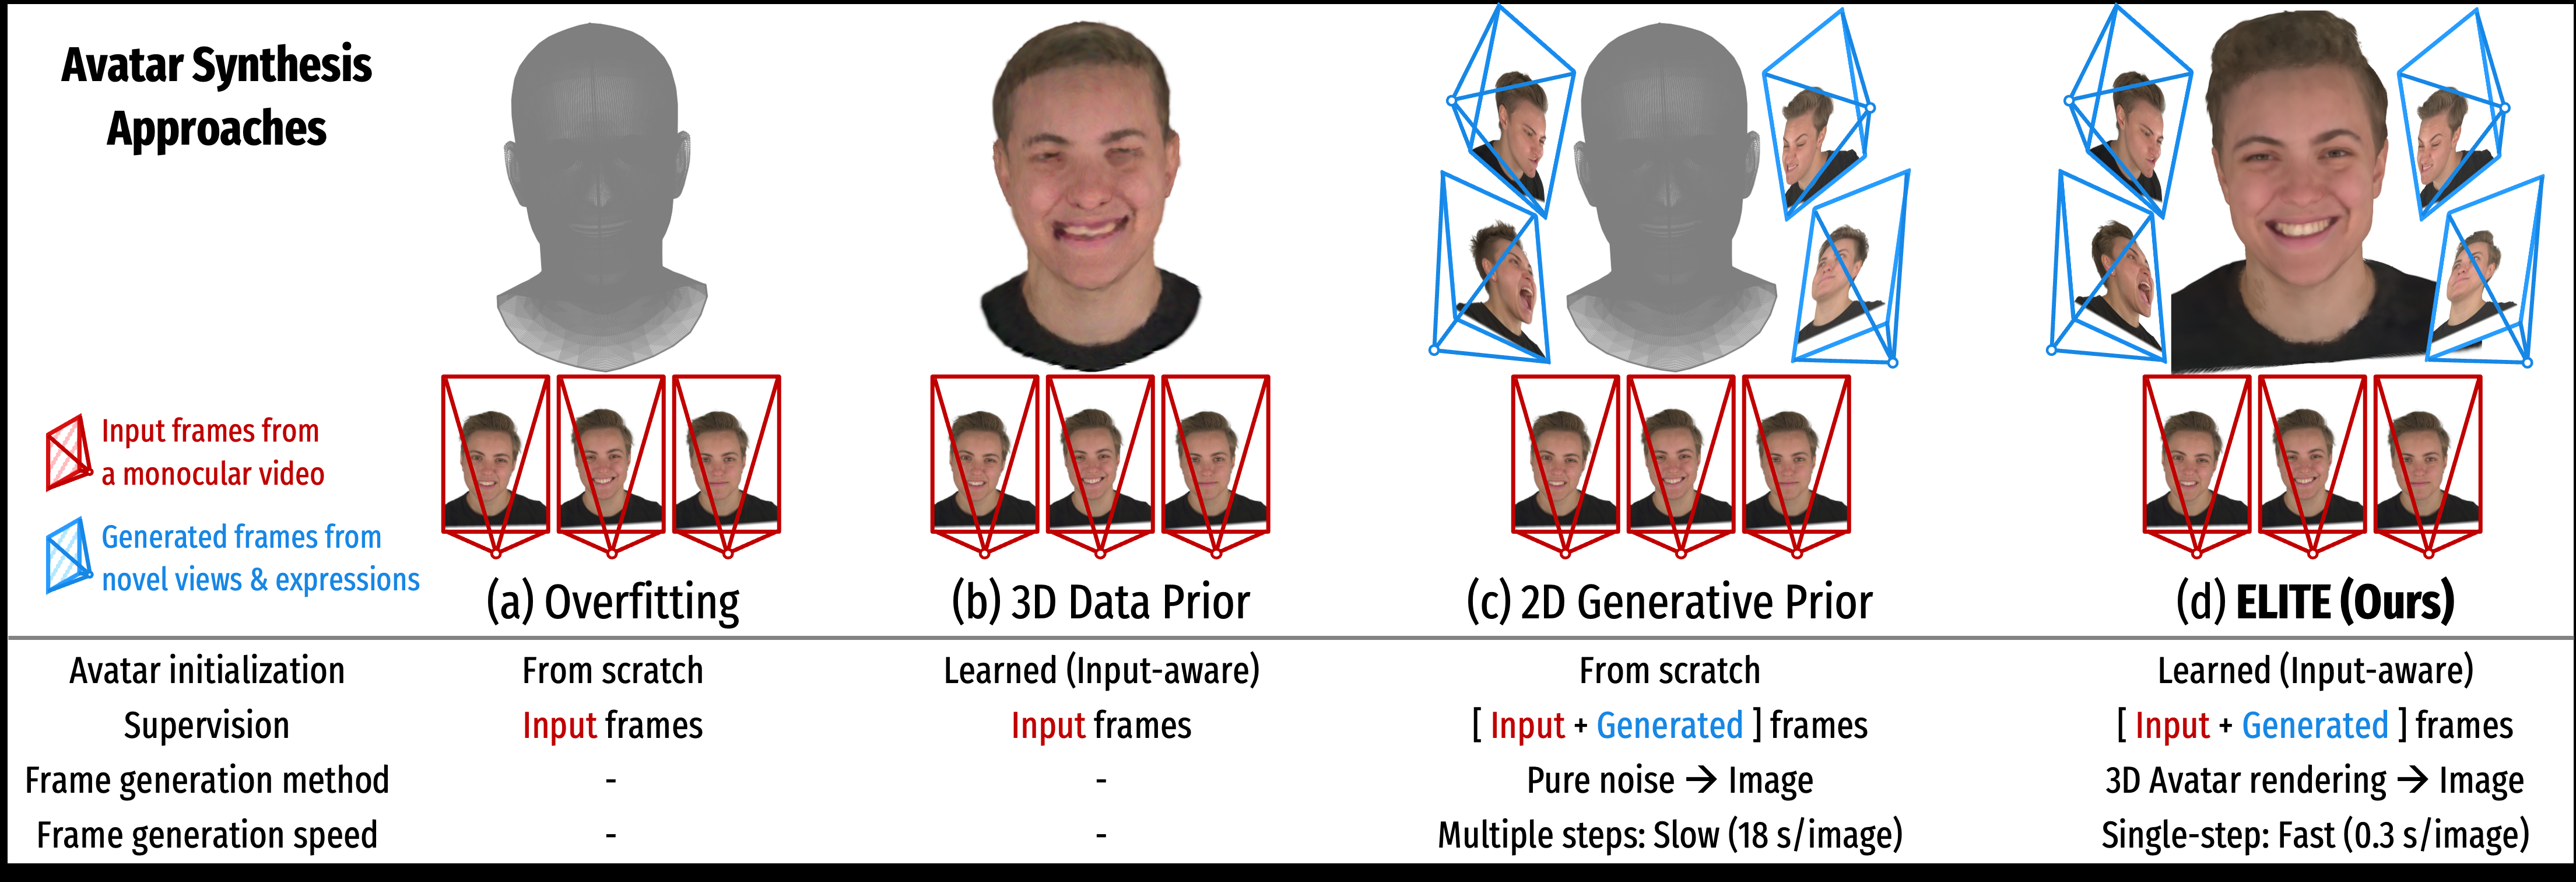
ELITE 的核心假设可以压成三句。第一,若把 FLAME canonical maps 直接映射为 Gaussian 参数图,就能明显缩短 per-subject personalization 的收敛路径。第二,若生成监督既覆盖 novel view / expression,又能保持 target identity,那么它比单纯重复使用少量真实帧更有价值。第三,这两类先验不是替代关系,而是互补关系:3D prior 提供结构着陆点,2D prior 提供密集身份证据。
这也是为什么后文的证据重点不应只看最终渲染 PSNR,而要看 Stage 2 的监督本身是否可信。否则“多训一轮”只是多一轮 hallucination。
MGPM 机制
ELITE 的 initialization 核心是 MGPM。它把 canonical FLAME UV texture map 和 geometry map 拼接为输入张量,形状是 H × W × 6,也就是 $[M_{tex}, M_{geo}]$ 的 $3+3$ 通道。输出则是与 UV 对齐的 2D Gaussian parameter map,形状是 H × W × 13,其中每个 texel 预测一组 3+3+4+2+1 通道:position offset、RGB、quaternion、scale、opacity。
结构上它是一个 FiLM-conditioned U-Net。纹理与几何先过分离卷积分支,因为二者统计量不同;几何分支在进入主干前先做 normalization。驱动侧则将 global rotation、jaw、eyes、neck、expression 等参数送入 MLP,再把聚合得到的 128-D driving embedding 通过 FiLM 调制 U-Net 特征。expression 维度在论文中明确给到 100-D,但包括 translation 在内的完整拼接维度总数 not specified。
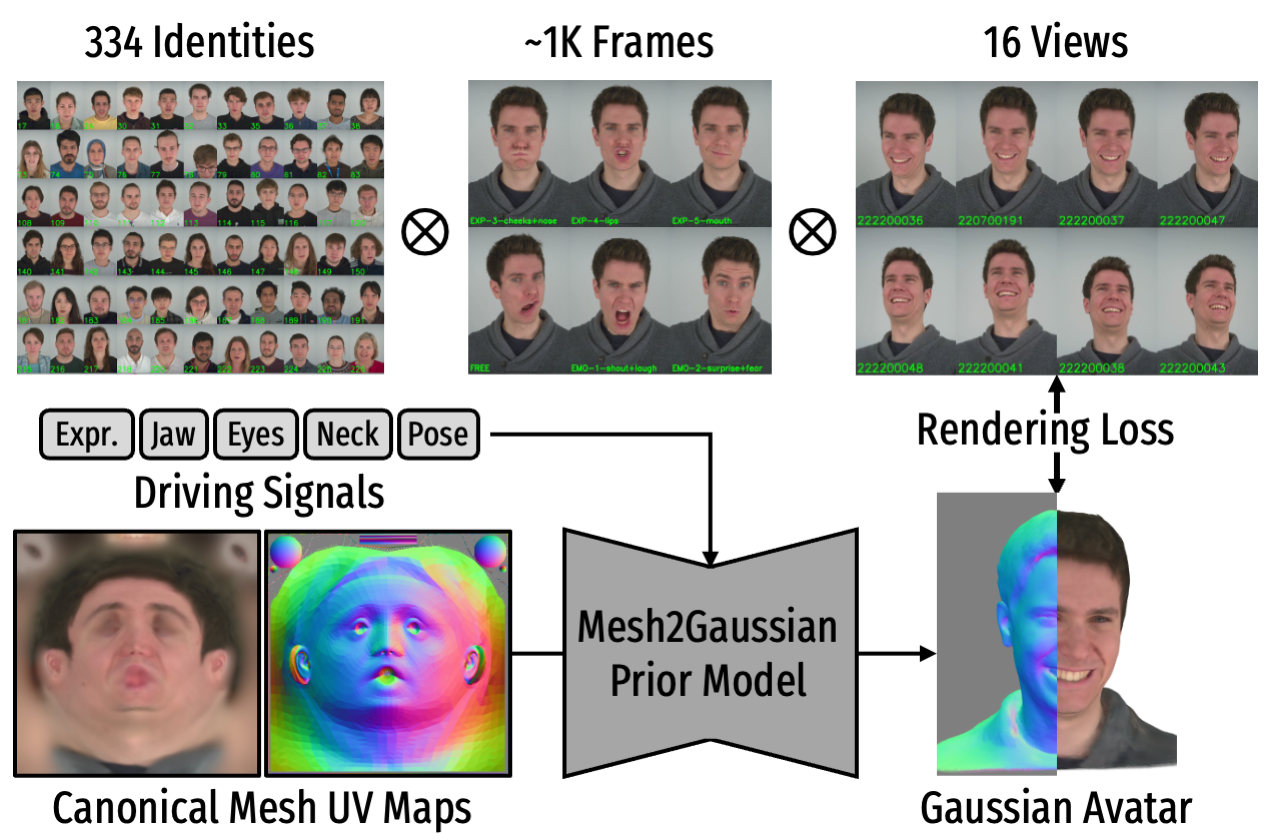
这种参数化有很强的工程含义。它把本来抽象的 avatar initialization 变成了一个对图像 backbone 友好的 per-texel 预测任务,因此自然享受卷积结构、局部一致性和 UV 对齐监督的好处。论文报告 MGPM 总参数量约为 36.2M,训练预算是 4 × RTX A6000 48GB 持续 2 days。在当前可直接核验的补充实验里,最宽的训练身份量级证据是 334 IDs 的设置,而最终完整训练子集与 batch size、绝对 LR、optimizer、seed 仍属于 not specified。
损失层面,论文明确给出重建项、LPIPS、depth distortion 与 normal consistency 的组合,但没有把每个权重和训练步数完整公开到可复现实验脚本粒度。也就是说,这里我们能确认“损失家族”和“模型形状”,却不能把具体超参数误写成已公开。
两阶段适配
ELITE 的 personalization 有三个关键状态:先由训练好的 prior 给出初值 $F_{\phi}$,再通过少量真实帧微调成 $F_{\phi*}$,最后引入 enhancer 生成的额外监督,把 avatar 推到最终状态 $F_{\phi★}$。这三步的角色不同,不能混成“一个 end-to-end block”。
Stage 1 的职责是把通用 3D prior 拉向当前 subject。论文明确默认使用 $N_{real}=3$ 张真实帧做重建监督,这里的“少量帧”不是拍脑袋,而是作者刻意把真实监督维持在稀缺场景中,来验证 initialization 是否足够强。Stage 2 则不直接修改生成器本身,而是把从当前 avatar 渲染出的 degraded novel-view 图像,与 clean reference 一起送进 enhancer,生成更像目标人的额外监督,再把这批 2D 证据蒸馏回 3D avatar。
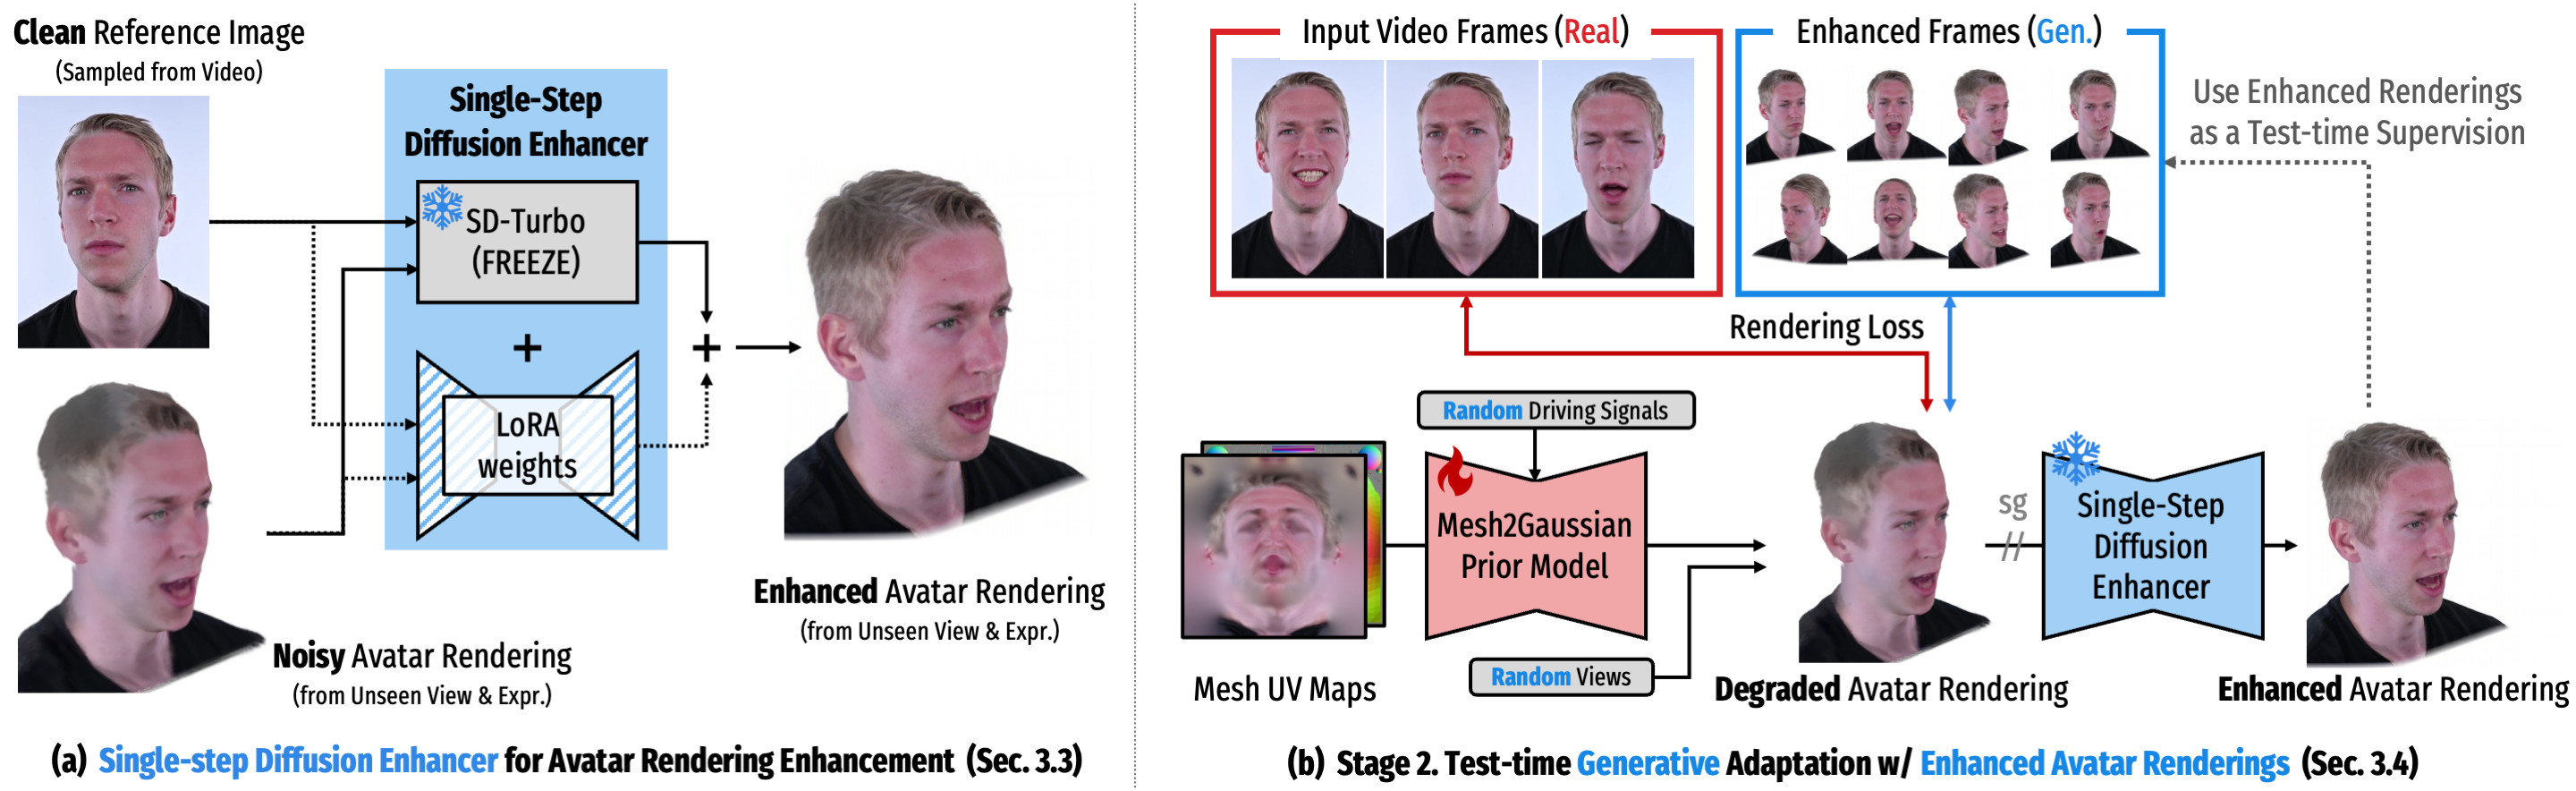
这就是 ELITE 真正的技术主张:Stage 2 不是再加一个 post-filter,而是把 reference-conditioned 2D enhancement 变成 subject-specific supervision production line。生成模型只是中间教师,最终要变好的仍然是 3D avatar 本体。
Enhancer 角色
enhancer 的训练数据不是随便抓几张对。论文报告它使用 10,688 个 triplets:degraded target render、heterogeneous clean reference、aligned clean ground-truth target。实现路线明确指向 SD-Turbo/DIFIX 风格的单步扩散增强:冻结 VAE encoder,只对 decoder 做 LoRA fine-tuning,并用 $L1 + LPIPS + Gram$ 约束既保留身份,也保留局部纹理统计。
训练预算也很明确:1 × A6000,约 6 hours。但更细的 LoRA rank、decoder 插入层、batch size、noise schedule 以及 Stage 2 中生成监督的具体数量 $N_{gen}$,官方论文与当前 README 证据都没有给出,因此都应标记为 not specified。这不是细枝末节,因为这些量会直接影响生成监督的稳定性与身份一致性。
数据流与状态
如果把 ELITE 写成数据流,而不是模块列表,它的结构会更清楚:源视频先经过 tracking 产出 canonical UV maps 与 driving 参数,MGPM 预测初始 Gaussian map,Stage 1 用真实帧把它收缩到当前身份,Stage 2 再用生成监督补 coverage,最后只保留个性化后的 avatar 进行渲染。
| 阶段 | 对象 | Shape / Dim | 语义 | 产生者 | 消费者 | 证据状态 |
|---|---|---|---|---|---|---|
| 输入 | raw source video | video | 单目个性化源视频 | 用户或 INSTA | tracking pipeline | official code |
| 预处理 | M_tex | H × W × 3 | canonical UV texture map | tracking / FLAME fitting | MGPM | paper |
| 预处理 | M_geo | H × W × 3 | canonical UV geometry map | tracking / FLAME fitting | MGPM | paper |
| 驱动 | driving vector | expression 100-D, aggregated 128-D, total not specified | 姿态、眼睛、jaw、neck、expression 与 translation 条件 | tracked motion parameters | driving encoder / FiLM | paper + not specified |
| 初始化 | 2DGS map | H × W × 13 | per-texel Gaussian parameters | MGPM / $F_{\phi}$ | renderer + adaptation | paper |
| Stage 1 | real-frame loss | N_real = 3 | 少量真实重建监督 | source frames | $F_{\phi*}$ optimization | paper |
| Stage 2 | degraded random render | image | 来自当前 avatar 的随机视角/表情渲染 | $F_{\phi*}$ renderer | enhancer | paper |
| Stage 2 | clean reference | image | 身份锚点 | source identity frame | enhancer | paper |
| Stage 2 | enhanced supervision | N_gen not specified | subject-specific novel-view target | enhancer | $F_{\phi★}$ adaptation | not specified |
| 输出 | final prior | avatar state | 最终可驱动 Gaussian head avatar | $F_{\phi★}$ | render_videos.sh | paper + official code |
这里最关键的认识是,ELITE 没有把 2D 和 3D prior 混成同一种能力。3D prior 的产品是结构化 avatar state,2D prior 的产品是更高质量的监督样本;Stage 2 的真正操作,是把后者蒸馏回前者。
证据审计
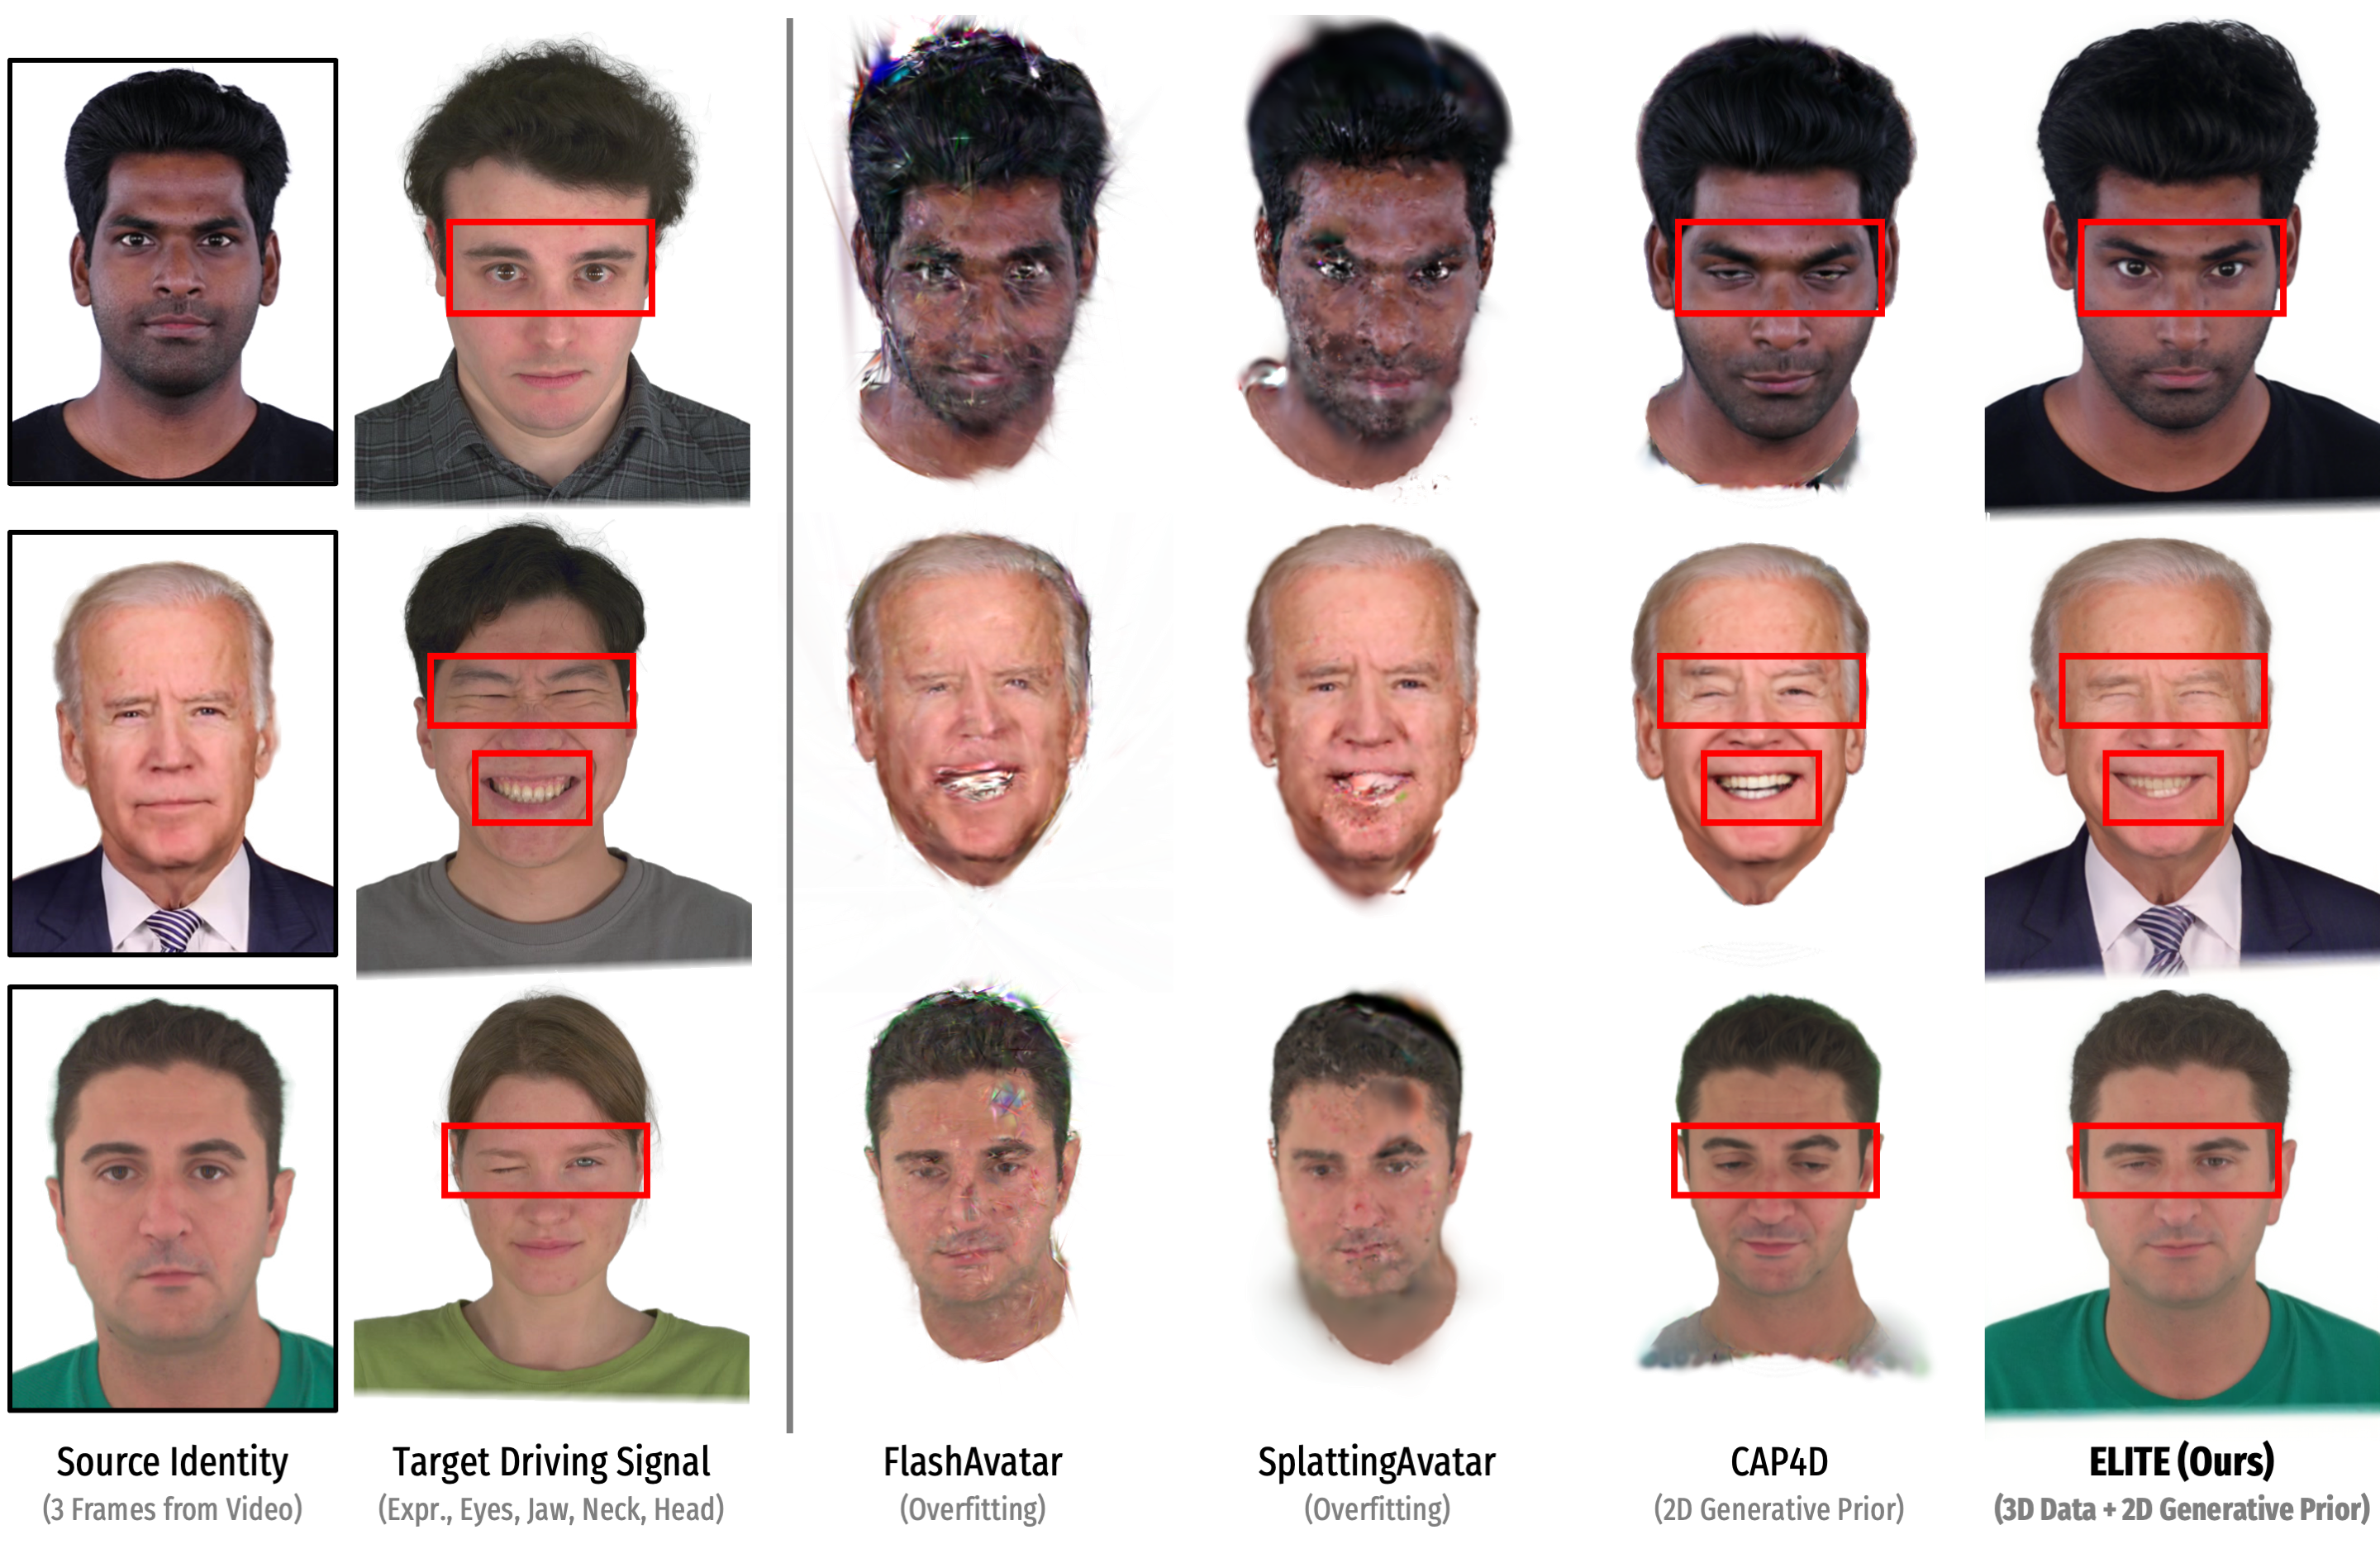
论文给出的主表不能被简单压成“ELITE 全面领先”。更精确的说法是:它在最终重建质量和身份一致性上相当强,但并非每个指标都第一。尤其是 SSIM,最优值仍属于 SplattingAvatar。
| Method | Duration | PSNR | SSIM | LPIPS | CSIM |
|---|---|---|---|---|---|
| FlashAvatar | 10 min | 20.875 | 0.8338 | 0.1420 | 0.5823 |
| SplattingAvatar | 15 min | 24.838 | 0.8831 | 0.0893 | 0.6406 |
| CAP4D | 400 min | 19.478 | 0.8675 | 0.0992 | 0.7064 |
| ELITE | 20 min | 25.220 | 0.8771 | 0.0732 | 0.7396 |
这张表支持的强结论是:ELITE 在 PSNR、LPIPS、CSIM 上领先,同时把 personalization 时间压到 20 min;但它并不是所有指标都最好,因为 SplattingAvatar 的 SSIM 是 0.8831,高于 ELITE 的 0.8771。这一点必须明写,否则就是过度概括。
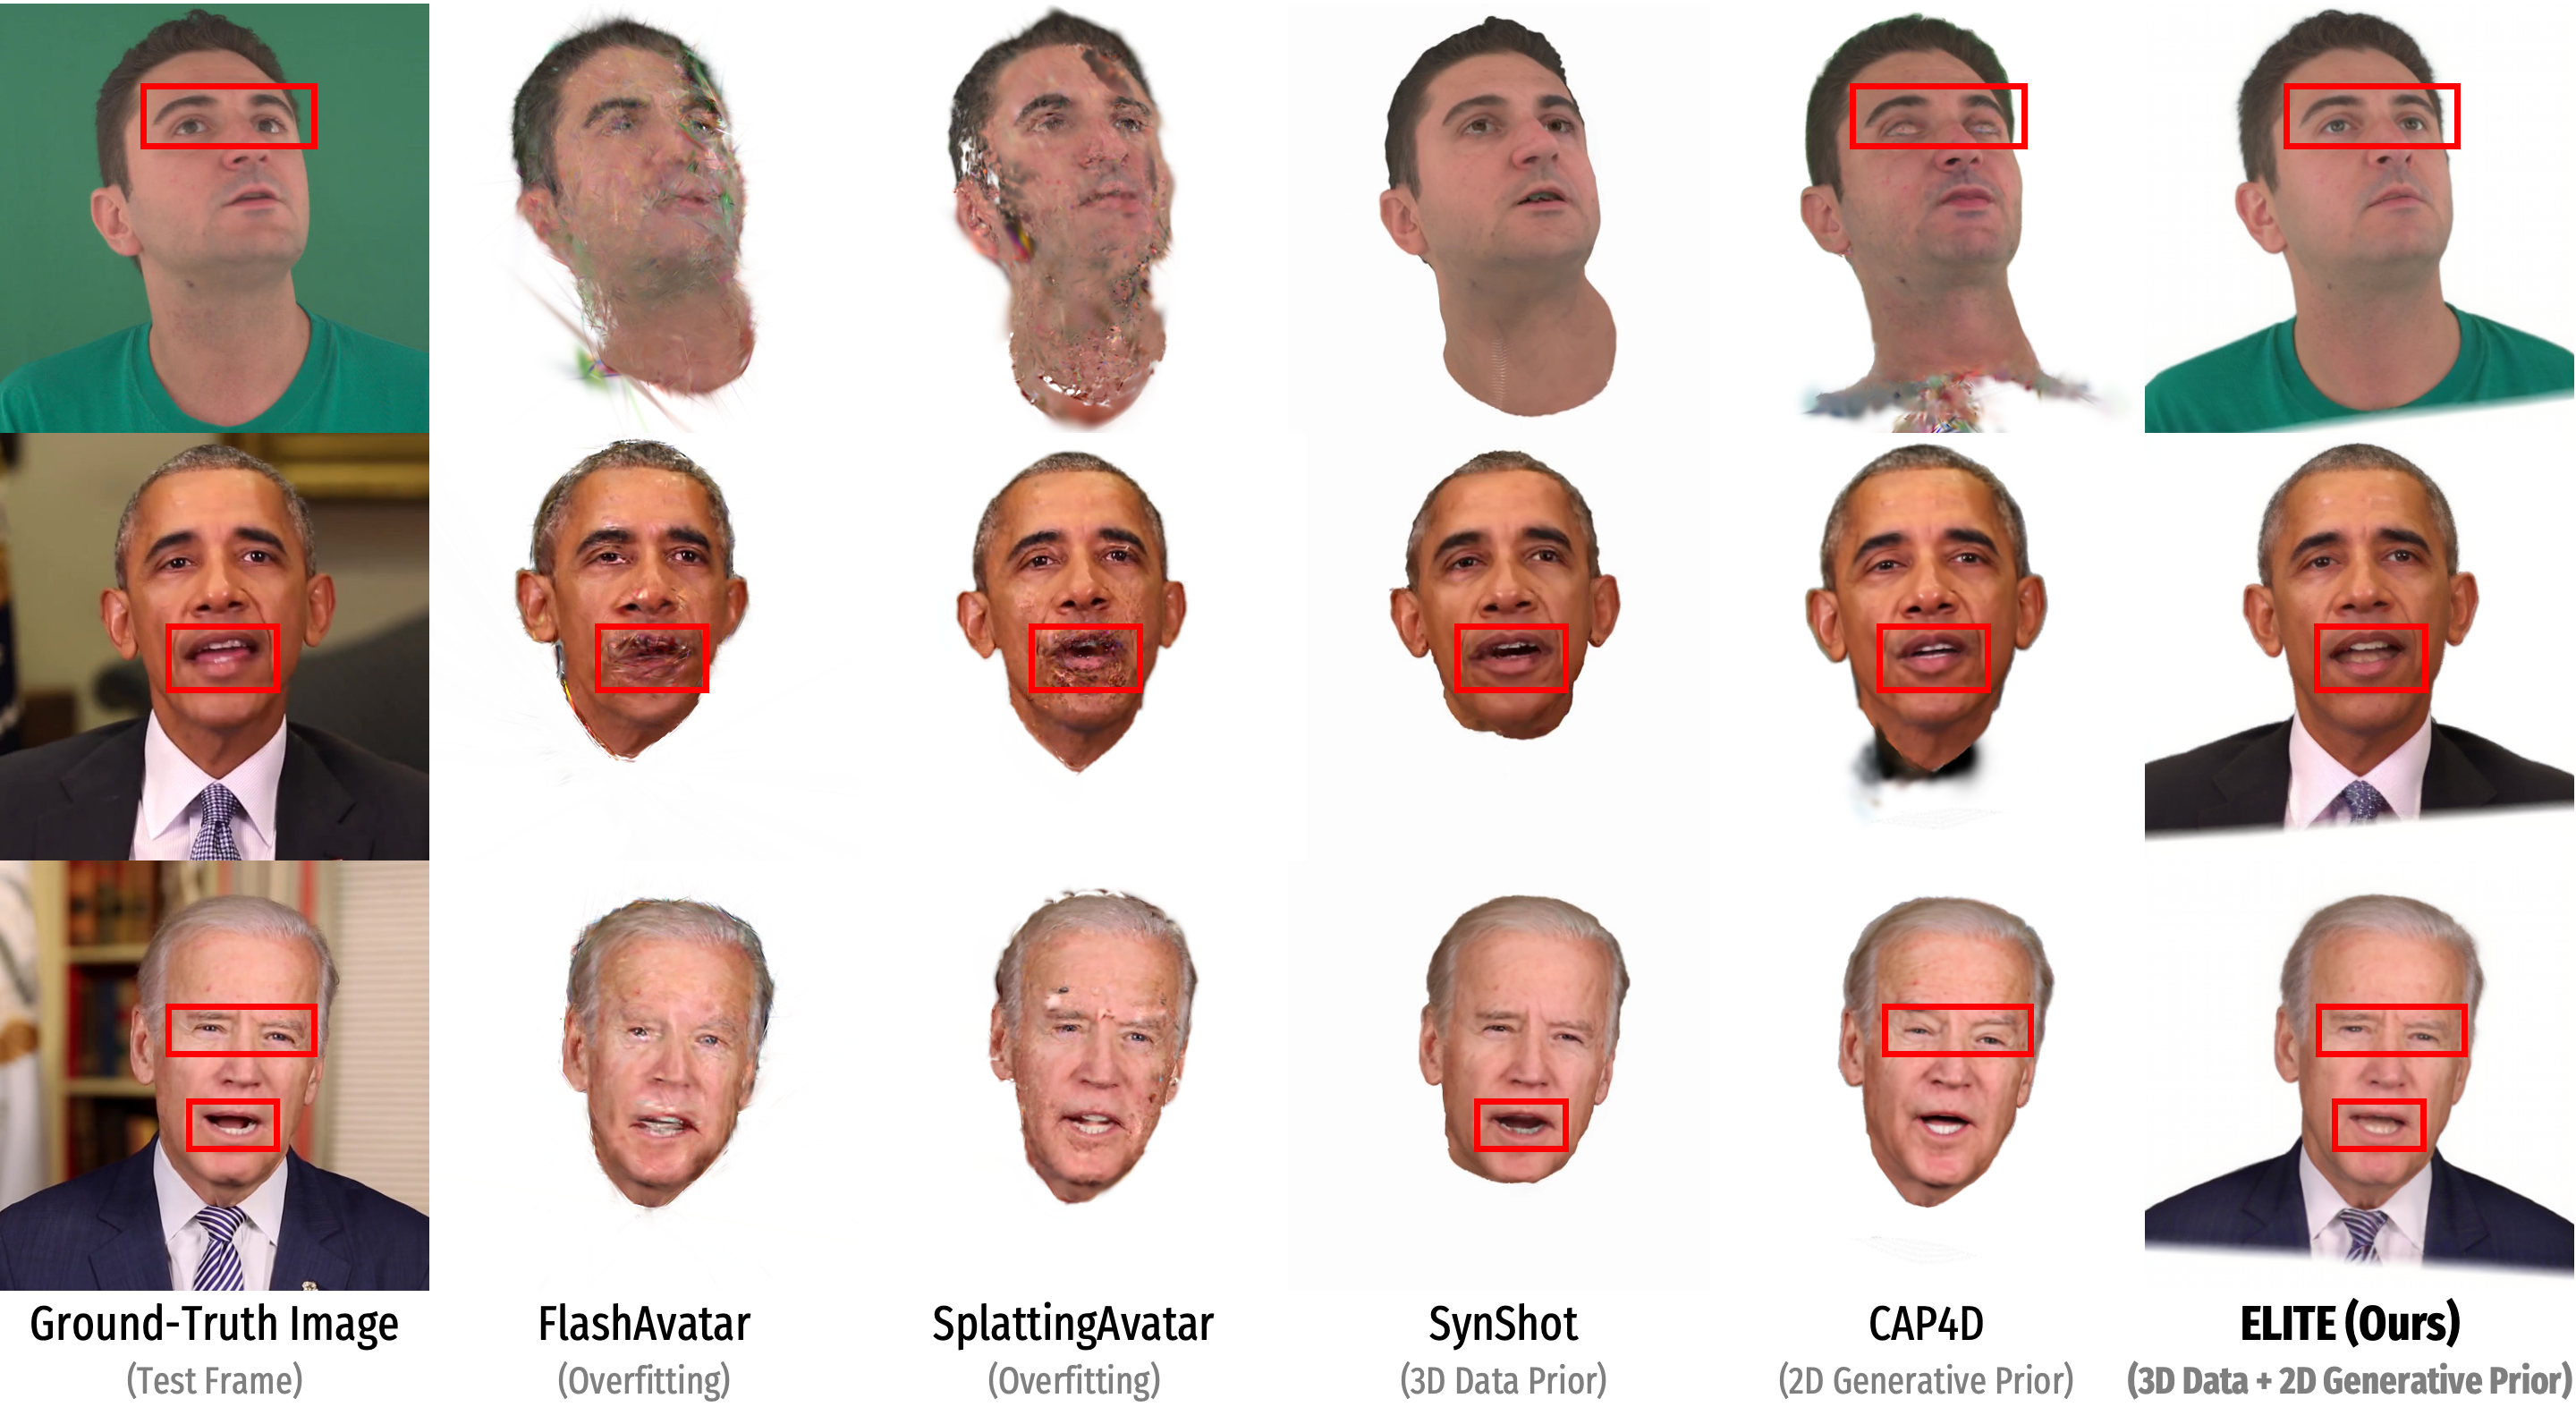
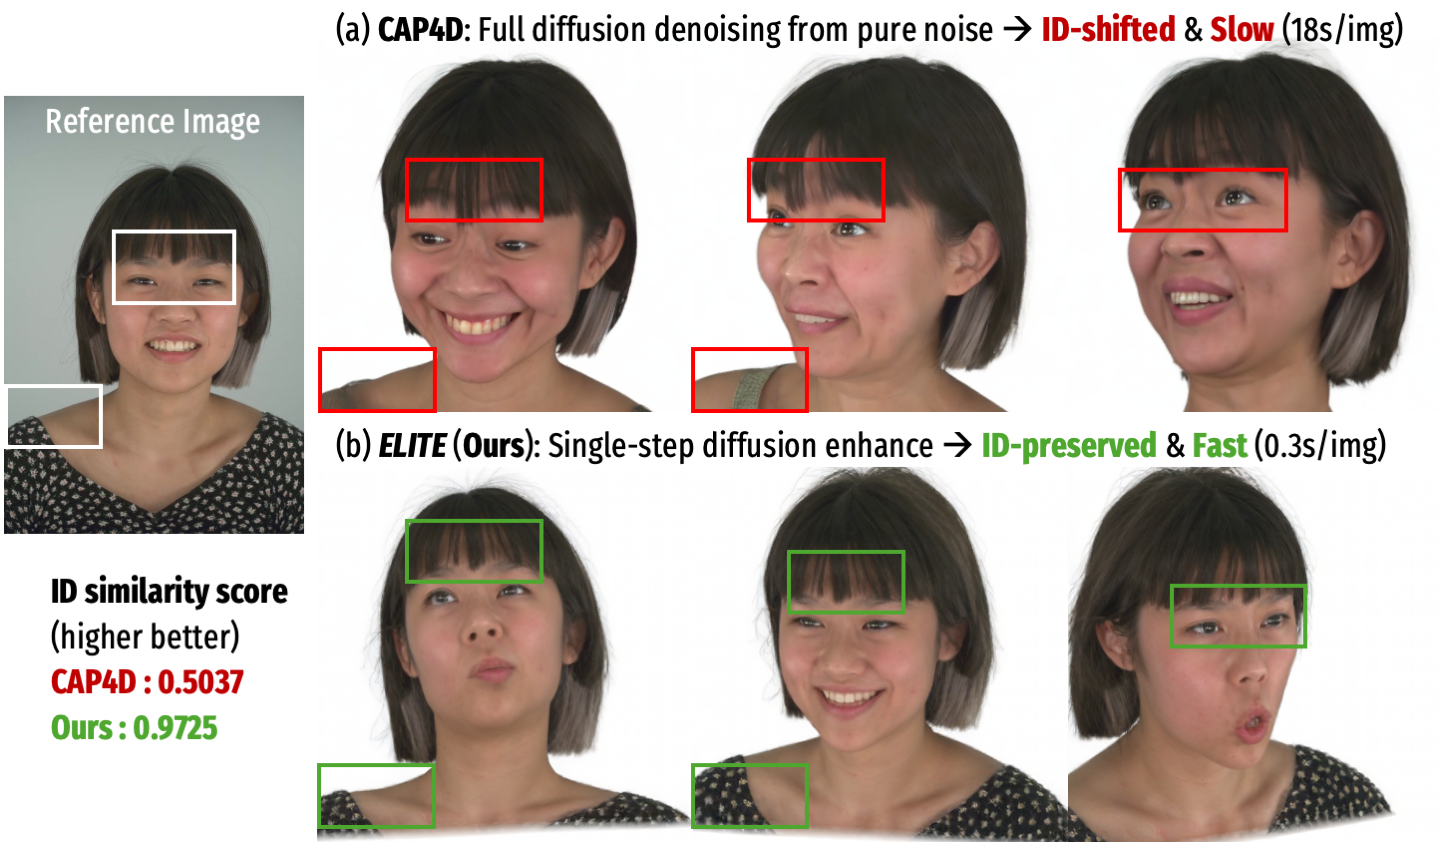
真正最能支撑 Stage 2 的,不是主表,而是生成监督本身的质量比较。CAP4D 的 synthetic supervision generation 约为 18 s/image,ELITE 为 0.3 s/image,这个 60× 只对应 supervision production,而不是整条个性化流水线都按同等比例提速。身份一致性指标更关键:CAP4D 生成监督的 CSIM 为 0.4144,而 ELITE 为 0.9793。这组数字说明作者不是单纯用更快的方式造图,而是在造“更像本人”的图。
另一张关键证据是 Table S1,对双先验互补性的支持相当直接:
| Prior Setting | PSNR | SSIM | LPIPS | CSIM |
|---|---|---|---|---|
| neither | 25.08 | 0.8701 | 0.0948 | 0.6918 |
| 2D-only | 26.30 | 0.8759 | 0.0664 | 0.7237 |
| 3D-only | 28.26 | 0.8843 | 0.0742 | 0.7129 |
| both | 28.68 | 0.8912 | 0.0585 | 0.7397 |
这个消融说明 appearance prior 和 geometry prior 的贡献方向不同。3D-only 在 PSNR / SSIM 上已经很强,意味着几何与视角一致性受益明显;2D-only 在 LPIPS / CSIM 上也有独立收益,说明它更直接服务于感知质量和身份细节。两者叠加后的 both 才是作者真正主张的协作点。
公平性与边界
论文并没有给出一个完全无 caveat 的 benchmark。第一,self reenactment 所依赖的 INSTA 片段整体 pose variation 有限,因此它更像“中等难度驱动分布”下的效果展示。第二,cross reenactment 没有 matched GT,因此只能定性比较。第三,SynShot 在本文里只能做 visual-only 对照,因为其实现与模型处于未公开状态,作者无法给出同协议 quantitative comparison。
这三点共同决定了本文证据应如何解读:ELITE 的主张在单目个性化、身份一致性和较快 adaptation 这几个点上是有力的,但若把它直接外推成“任何姿态、任何驱动、任何 benchmark 全面压倒 baseline”,就超出了现有证据。
60× 监督生成速度改善扩写成整条流程同尺度提速。更准确的说法是,它把 CAP4D 的 supervision generation 从 18 s/image 压到 0.3 s/image,把 personalization duration 从 400 min 压到 20 min,并用更高的 CSIM 让 Stage 2 有了方法学上的正当性。复现路径
从官方代码能核到的最低限度复现边界是明确的:环境测试于 Ubuntu 24.04、CUDA 11.8、RTX A6000 48GB;安装依赖包括 pytorch3d、基于 diff-surfel-rasterization 的自定义 surfel rasterizer,以及作为子模块安装的 vhap。这些是“能否跑起来”的先决条件,而不是论文中可忽略的工程细节。
数据与资产方面,README 明确要求用户自行注册并下载 FLAME 相关资源,再准备 INSTA 源视频与官方 checkpoints。这里最需要克制的表达是:官方仓库说明了 checkpoints 的放置路径,但我们在当前阅读范围内并没有把下载链接、可用性与版本一致性逐一核实到可执行状态,因此不能暗示“checkpoint 已经核验可直接下载”。
官方脚本入口也很清楚,最小 smoke path 应是:
bash scripts/process_source_video.sh {ID}
bash scripts/personalize.sh {ID}
bash scripts/render_videos.sh {ID} {MOTION_NAME}
其中 process_source_video.sh 负责预处理、face 3DMM tracking 与后续 NeRF/3DGS 格式导出;personalize.sh 执行 ELITE 的 test-time adaptation;render_videos.sh 以处理好的 motion sequence 渲染最终视频。README 当前只声明支持两种输入分辨率:512x512 与 802x550。若输入分辨率、tracking 稳定性或 FLAME 注册不匹配,复现很可能在个性化前就掉链子。
许可也要分开看。主仓库是 Apache-2.0,但 FLAME 资产、INSTA 数据和 third_party 组件各有各的许可边界。换句话说,“源码可复用”不等于“全部数据与模型资产都可自由再分发”。
局限与风险
论文明确承认 unusual lighting 与复杂 material 仍是薄弱环节。这并不意外,因为 MGPM 的 canonical UV 表达和 Stage 2 的 reference-conditioned enhancement 都偏向在“人脸主体统计稳定”时工作,遇到镜面高光、半透明材质或强环境色偏,就会把真实外观变化与身份细节纠缠在一起。
配饰问题尤其典型。论文特别提到 glasses 往往只会被烘焙进纹理,而没有真实 geometry 支撑。这意味着在 novel view 下,配饰的遮挡关系和法线结构未必正确。换句话说,ELITE 当前更像在做人脸与头部表面的 avatar,而不是完整物理一致的 accessory-aware scene model。
另一个限制来自数据分布。若 prior 训练数据对 pose、肤色、妆容、配饰或年龄段覆盖不足,双先验协作并不会自动修正这些偏差。生成式监督还能带来额外的 misuse 风险,例如身份挪用、fingerprinting 规避和 forensics 干扰。因此,作者把 fingerprinting / forensics 作为后续必要方向是合理的,而不是形式化免责声明。
可复用判断框架
读 ELITE 最值得带走的,不是“又一个 benchmark 表格”,而是一套可复用判断框架:当一个 avatar 系统同时声称自己又快又像时,先问它的 3D prior 负责什么、2D prior 负责什么,二者的证据是否在同一层级上闭环。若 2D prior 只是把图修得更漂亮,却没有蒸馏回 avatar 本体,那它只是后处理;若 3D prior 没法把 initialization 推进到足够好的结构区域,那再多生成监督也只是在坏底座上修图。
ELITE 的说服力恰好来自这两个问题都被回答了一部分。MGPM 用 H × W × 6 到 H × W × 13 的 UV-aligned dense prediction,把结构初始化问题做成了可训练的图像到图像映射;Enhancer 则用 10,688 triplets 和更高的身份一致性,把 Stage 2 的监督变成了有证据可审的模块。它仍有不少 not specified 的工程细节和泛化边界,但“3D 打底、2D 补证据、再蒸馏回 3D”这条主线是成立的。
Recommended citation: Youwang et al., ELITE. CVPR 2026; arXiv:2601.10200v1.
Download Paper