面向自我改进的 Harness 工程
原文:Harness Engineering for Self-Improvement,作者 Lilian Weng,发表于 2026 年 7 月 4 日。
本文按原文顺序整理,保留原有章节、表格、公式、图片与参考文献;图内英文不作改动,图注使用中文。译者已按原作者的翻译说明 在发布前邮件告知作者。原文之外的补充思考统一放在文末。
递归自我改进(recursive self-improvement,RSI)的概念可以追溯到 I. J. Good(1965)。他把“超智能机器”定义为这样一种系统:它能够在所有智力活动上超越人类,并能设计出更好的机器来改进自身。Yudkowsky(2008)则用“递归自我改进”描述一个特定的反馈循环:AI 利用当前的智能,改进产生这种智能的认知机制。
在现代 AI 中,这种反馈循环可以指模型直接重写自己的权重;也可以采用更宽泛的理解,即模型改进其训练流水线和部署系统,由此产生一个更优秀的后继模型,让它在具有经济价值的任务上取得更好的表现。前沿实验室的实践已经表明,AI 研究开发的速度正在大幅加快(Anthropic;OpenAI)。
我之所以特意提到“部署系统”,是因为位于原始模型与真实世界上下文之间的这一层,似乎与模型的原始智能同样重要。这里的原始智能,是指预训练结束后立即进行评测所测得的能力。Claude Code 和 Codex 等成功的 coding agent 产品已经说明,Harness 是 AI 部署中的重要组成部分。所谓 Harness,就是围绕基础模型搭建的系统。它负责组织执行,并决定模型如何思考和规划、如何调用工具和采取行动、如何感知和管理上下文、如何保存制品,以及如何评估结果。
本文将聚焦 Harness 工程相关研究,以及它如何推动 RSI。近期许多关于自动化研究、自我改进智能体和演化式程序搜索的工作,都可以围绕这个问题来组织。模型自博弈、合成数据、测试时训练,以及更宽泛的持续学习研究,同样符合 RSI 的愿景,例如 Yuan et al.(2024)、Chen et al.(2024)、Zhao et al.(2025) 和 Choi et al.(2026),但它们不是本文的重点。
Harness 设计模式
与早期的智能体框架相比,后者常被概括为“agent = LLM + memory + tools + planning + action”,Harness 工程还包含了工作流设计(例如循环工程)、评估、权限控制和持久状态管理。它已经不再只是提示词模板,而更接近运行时和软件系统设计:模型如何观察、行动、记忆、自检和改进。
Harness 的设计应有意保持简单和通用,以便泛化。设计时很可能需要借鉴现有的软件工程实践,从模型的预训练知识中获益。操作系统与 Harness 之间也存在很强的类比。与操作系统相似,Harness 应封装复杂逻辑,同时保持接口简单。与此同时,配置、工具接口和其他协议可能会逐渐形成行业标准。
模式一:工作流自动化
为模型定义一个可以操作、测试和迭代的工作流,是实现自动化的一项关键设计。Karpathy 的 autoresearch 仓库提供了一个简洁示例,说明这样的工作流可以如何搭建。一种常见工作流会沿着目标导向的循环运行:规划、执行、观察或测试、改进,然后再次执行,直到目标实现。这个过程也可能主动向用户提问,以澄清任务规格或执行偏好。
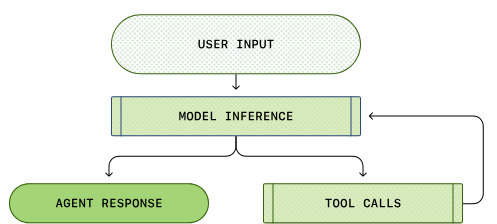
图 1:简化的 Codex 智能体循环。智能体调用工具,工具响应会影响模型的下一次生成。图片来源:OpenAI 关于 Codex agent loop 的文章。
这张工作流图还强调,模型会分析自己的执行轨迹和失败案例,再通过一个“智能体运行时”迭代推进任务,而不是依赖静态的提示词模板。
模式二:将文件系统用作持久记忆
在长周期智能体系统中,一个反复出现的模式,是用简单的方式控制丰富的状态与制品。Harness 不应把完整工作流和所有日志都塞进上下文,而应把持久状态保存在文件中。在长周期的 agentic rollout 里,实验日志、代码差异、论文摘要、错误轨迹和过去的 rollout 轨迹等制品,往往会远远超过模型训练时所见的上下文窗口长度。
学习如何读取、写入和编辑文件系统,通常是通过 bash 命令完成,是 LLM 的一项基础技能。因此,以文件这种简单形式管理持久记忆,自然能够从核心模型能力的提升中受益。
模式三:子智能体与后台任务
Harness 可以生成多个子智能体并行执行,同时监控后台任务。当主智能体需要搜索多个假设、并发运行实验,或者委派相互隔离的子任务而又不想污染主上下文时,这种能力很有用。父智能体因此需要一个小型进程管理器,用来启动任务、检查日志、取消失败运行,并把结果合并回主智能体线程。
关键设计选择,是让并行执行变得显式且可检查。如果子智能体的输出只存在于临时聊天上下文中,它们很快就会过时并被隐藏起来。把输出保存为文件、日志和状态记录后,模型就能从中断中恢复,也能基于自己的执行历史继续推理。
案例研究:Coding Agent Harness
Claude Code、Codex、OpenCode 和 Cursor 风格的智能体之间,主流 coding agent 的核心接口已经趋于稳定。它们通常采用下面这样的循环:
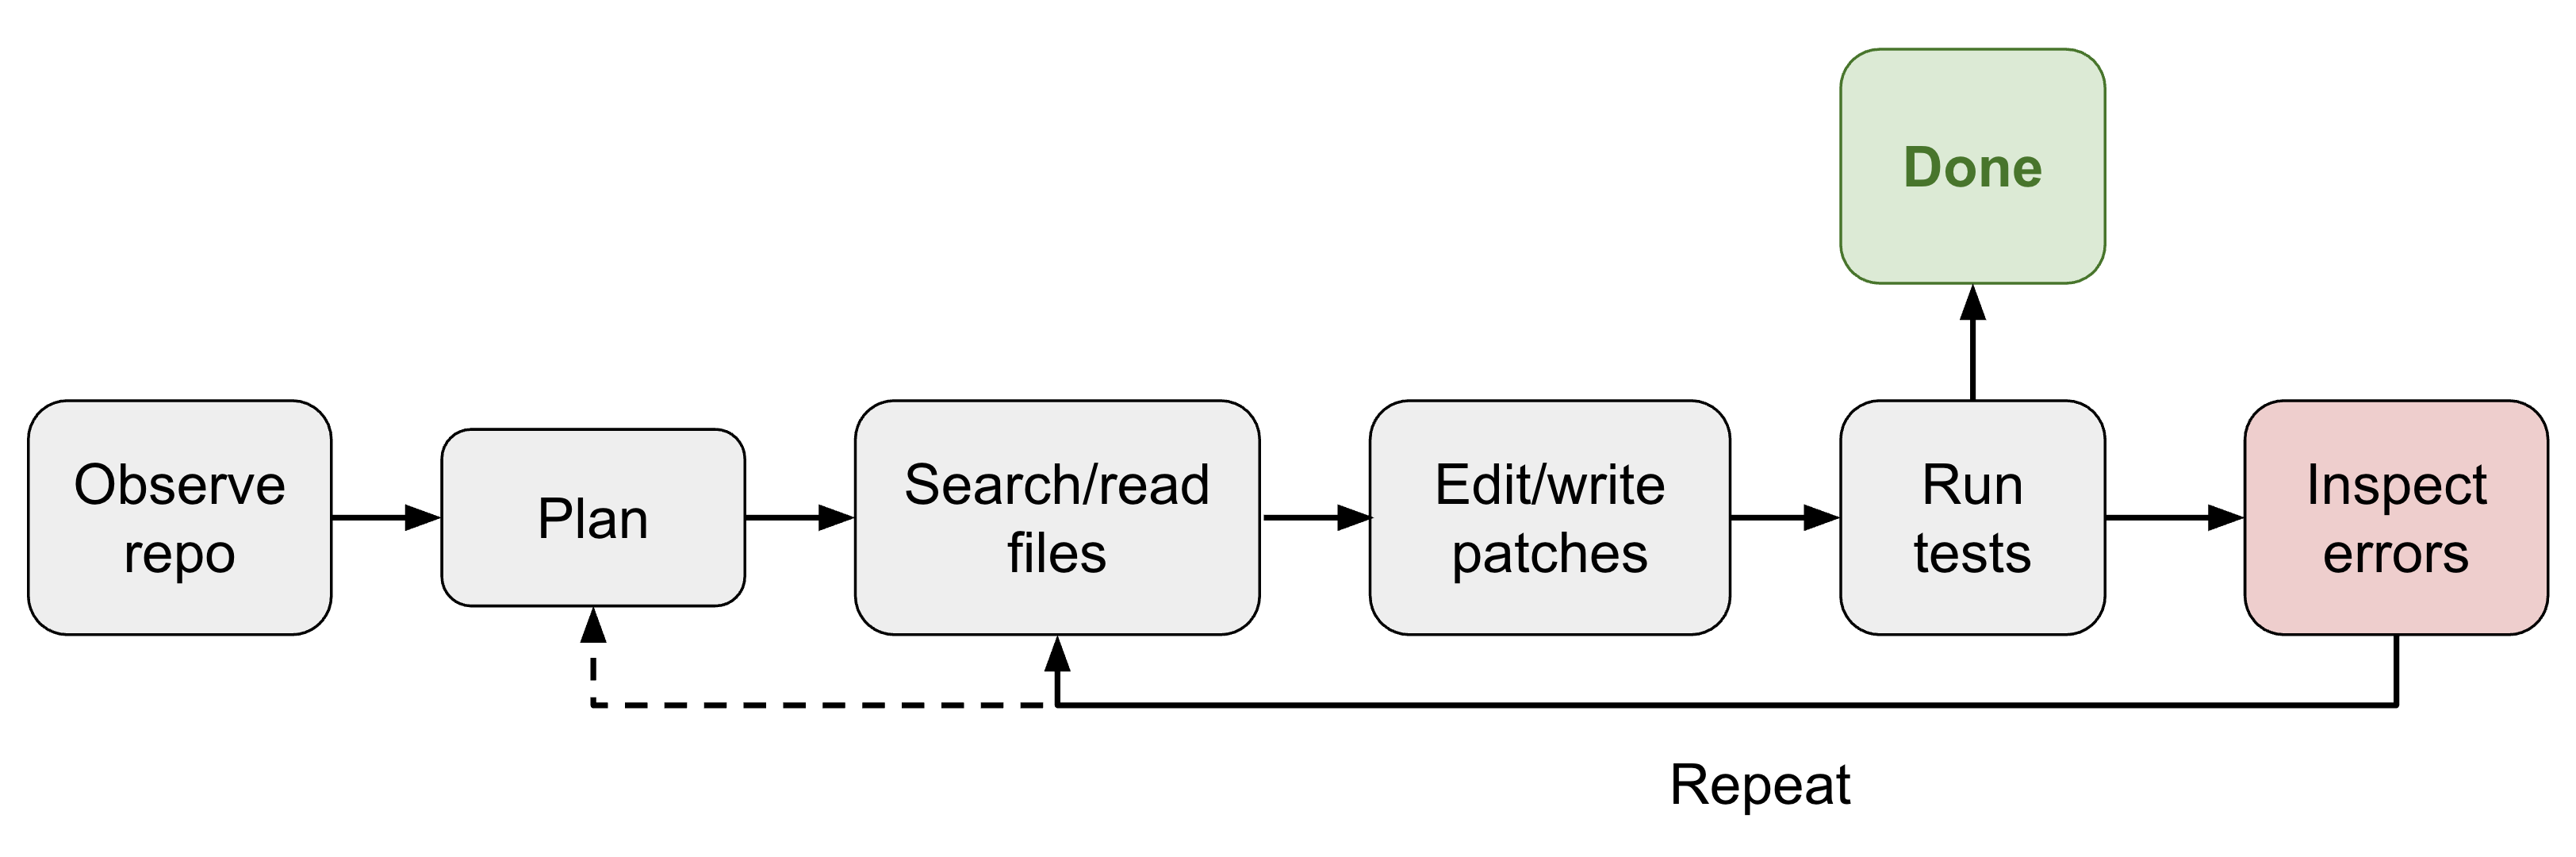
有了一组工具,coding agent 就能够在给定仓库中开发和调试问题,这与人类开发者配备 IDE 很相似。
下面并不是一份完整清单,仅用于演示。如果感兴趣,可以继续阅读这个仓库。
| 工具组 | 工具定义 |
|---|---|
| 文件系统 | 文件发现:glob、grep、ls文件读取: read、read_many文件修改: write(写入一个完整的新文件)、edit(精确匹配字符串并替换)、multi_edit、apply_patch(应用结构化 patch/diff) |
| Shell 执行 | 运行命令:bash、PowerShell |
| IO | lsp,以及 git_status、git_diff、git_commit 等 git 工具 |
| 外部上下文 | MCP 工具、Skills |
| Web 搜索 | web_search、web_fetch、浏览器工具 |
| 制品 | 读取文档和图片;生成 HTML、图片 |
| 后台进程 | 例如 CronCreate、CronDelete、CronList |
| 智能体委派 | 例如 spawn_agent、resume_agent、wait_agent、list_agents、close_agent、interrupt_agent 等 |
Harness 层与核心智能,孰轻孰重?
我们很难预测未来的 RSI 会在多大程度上依赖 Harness 工程,但近期的 RSI 路径不太可能从模型直接重写自身权重开始。我对近期可行路线的预测如下:
- Harness 工程将朝着元方法论的方向发展,也就是改进“获得更好答案的机制”,而不只是改进答案本身。Harness 系统本身将成为优化对象,启发式规则会减少,通用机制会增多。
- 反过来,成熟的 Harness 会为模型自我改进循环带来自动化研究能力;更聪明的模型又能防止 Harness 被过度设计,让整个系统保持可持续。
最终,许多 Harness 层面的改进可能会被内化为核心模型行为,但与外部上下文和工具交互的接口仍会保留下来。我们已经在提示词工程上看到了这个模式的温和版本:随着指令微调和模型推理能力提升,人工提示技巧不再那么重要,但明确目标、约束、上下文和评估的需要并没有消失。
Harness 优化
Harness 系统中优化对象的演进,大致可以写成:指令提示词 → 结构化上下文 → 工作流 → Harness 代码 → 优化器代码。随着模型越来越聪明、越来越强大,我们开始转向更复杂的优化目标和更通用的方法。
上下文工程
随着智能体任务的时间跨度显著增加,如果只是把所有工具响应和模型生成不断追加到上下文里,规模很快就会失控。上下文管理层需要为 LLM 构造更有结构、更简洁的上下文,同时管理持久状态。毫无疑问,长上下文研究会继续进步;但在现阶段,长上下文智能与上下文工程有时是相互交织的。
Agentic Context Engineering(ACE;Zhang et al. 2025)把上下文看作一份不断演化的工作手册,而不是一段越来越长的提示词。它包含三个组件,共同维护一份由条目组成的上下文手册;每个条目都有标识符和描述。
- Generator:生成任务轨迹,并引用手册条目。
- Reflector:从成功和失败轨迹中提炼洞见。
- Curator:以增量、逐条的方式更新结构化上下文。
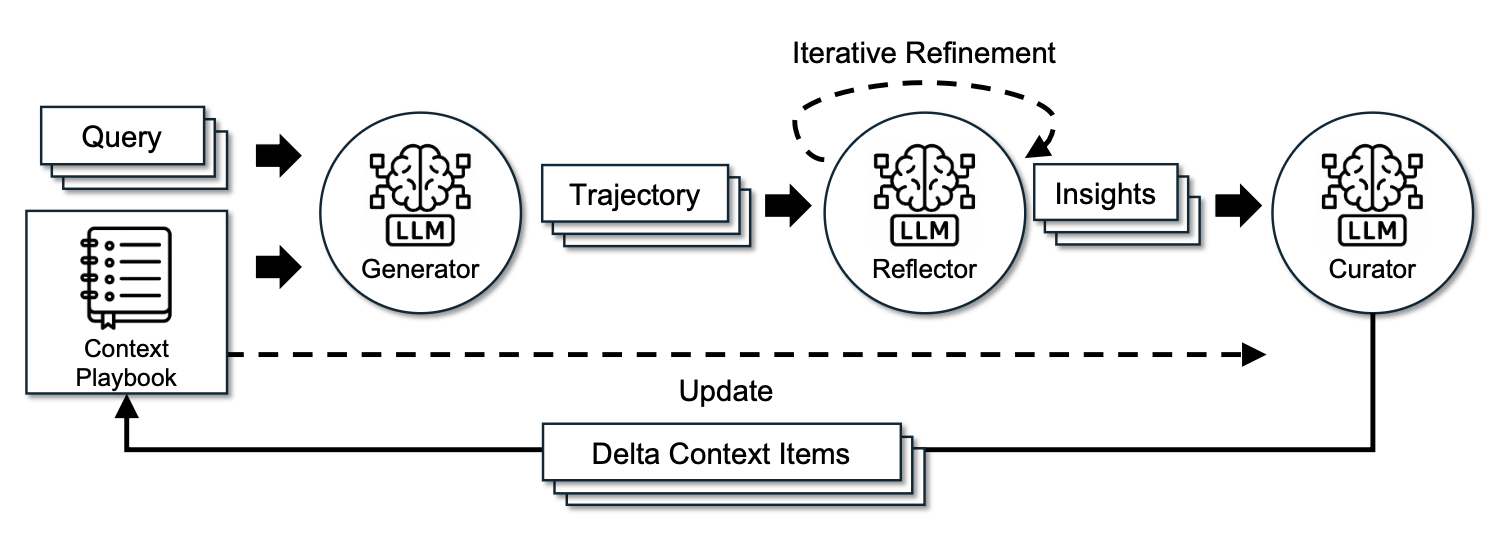
图 2:Agentic Context Engineering(ACE)框架。图片来源:Zhang et al. 2025。
为了防止迭代重写过程中的上下文坍缩和简洁性偏差,ACE 做出了一项关键设计:Curator 不会重写一整块提示词。它输出的是一组结构化、逐项列出的条目,每项采用“标识符、描述”的形式;随后,确定性逻辑会把这些条目合并进结构化上下文日志。上下文条目还会定期细化和去重。
ACE 从 rollout 中学习洞见,让我们朝着自主管理记忆迈进了一步;不过,它的更新规则和整体工作流仍由人工设计。为了走向更具自我改进能力的循环,Meta Context Engineering(MCE;Ye et al. 2026)把机制,即“如何管理上下文”,与制品内容,即“上下文里有什么”,分离开来:在元优化层执行 skill 演化,在基础层执行上下文优化。
一项 MCE skill $s \in \mathcal{S}$ 定义一个上下文函数 $c_s=(\rho_s,F_s)$,把输入 $x$ 映射为上下文 $c=F_s(x;\rho_s)$,其中:
- $\rho_s={\rho_1,\dots,\rho_m}$ 是静态组件,例如提示词、知识库和代码库。
- $F_s={F_1,\dots,F_k}$ 是动态操作,例如搜索、选择、过滤和格式化。
这个双层优化过程,要在给定 skill $s$ 时,基于训练数据找到最佳上下文 $c_s^*$;外层循环则寻找能在验证集上取得最佳表现的最优 skill:
\[\text{内层:}c_s^*=\arg\max_{c_s}J_\text{train}(c_s;s) \qquad \text{外层:}s^*=\arg\max_{s\in\mathcal{S}}J_\text{val}(c_s^*)\]Skill 数据库会跟踪过去的 skill、上下文函数和评估指标历史:
\[\mathcal{H}_{k-1}=\{(s_i,c_i,J_i^\text{train},J_i^\text{val})\}_{i=1}^{k-1}.\]给定任务 $\tau$,元层智能体会对过去的 skill 执行 agentic crossover,创建一项新 skill:
\[s_k=\text{crossover}(\tau,\mathcal{H}_{k-1}).\]随后,基础层上下文工程师执行 skill $s_k$,并在当前 skill 的指导下,根据 rollout 反馈 $\mathcal{R}_k$ 学习上下文函数:
\[c_k=\text{engineer}(\tau,s_k;c_{k-1}^*,\mathcal{R}_k).\]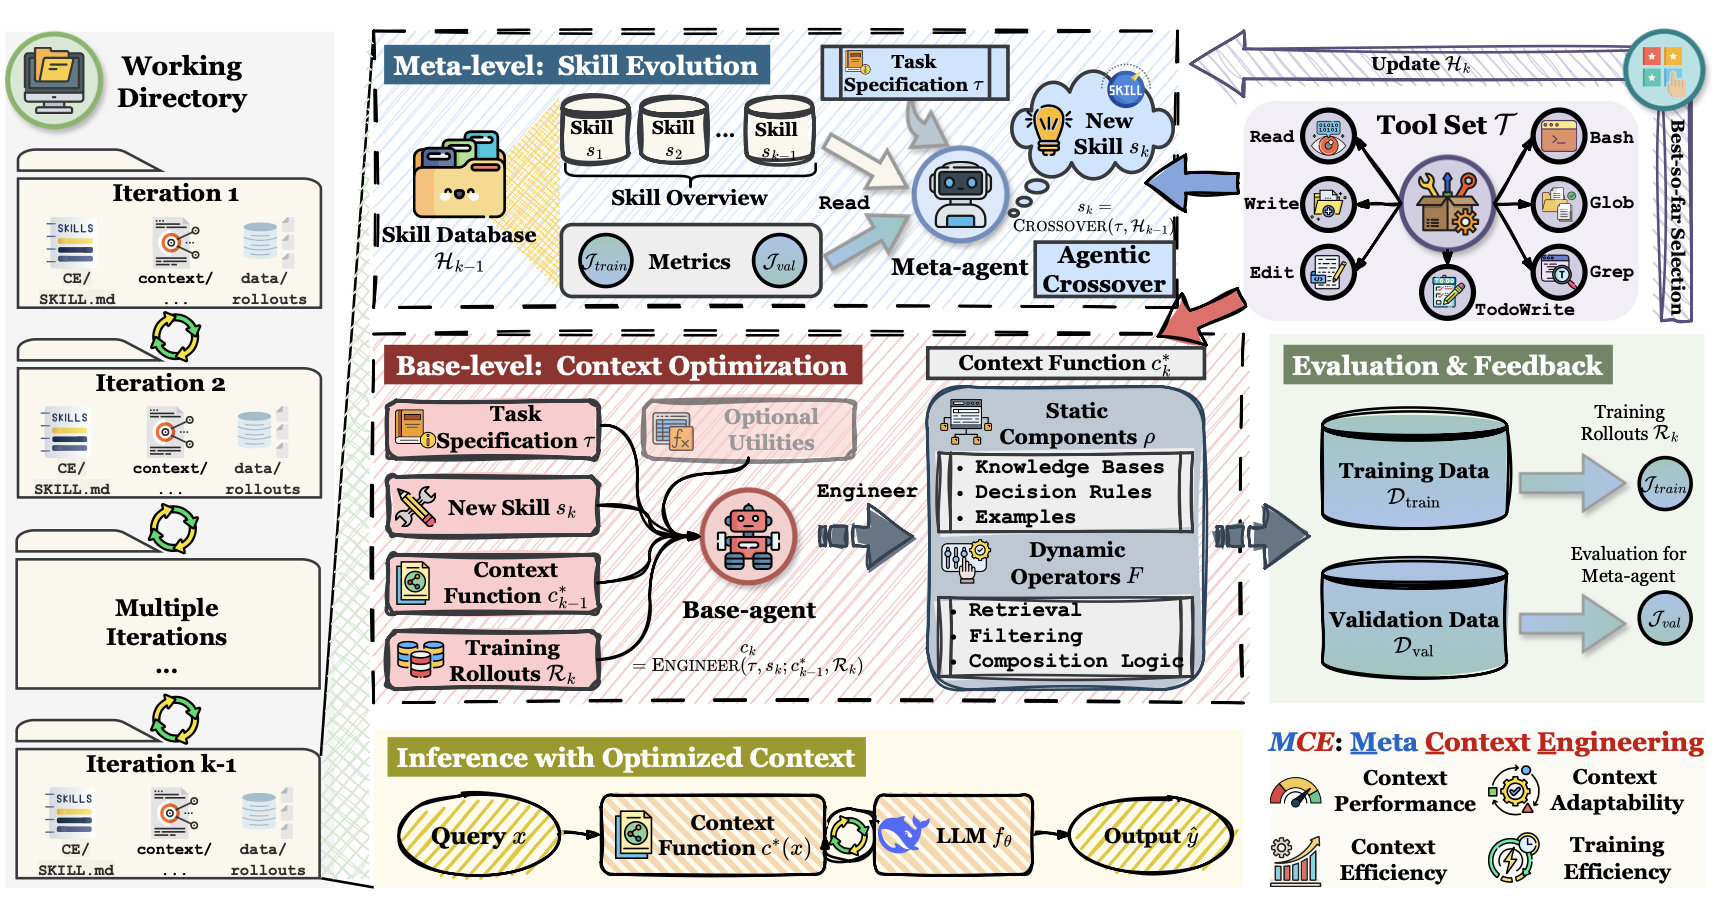
图 3:Meta Context Engineering(MCE)框架。元层 skill 演化负责搜索上下文管理机制,基础层负责优化任务上下文。图片来源:Ye et al. 2026。
MCE 不像 ACE 那样,强制规定一种关于上下文结构的启发式规则。它使用自由形式的 skill 保存任务中最重要的知识,并让 skill 与受 skill 约束的上下文共同迭代演化。从实现上看,上下文函数 $c$ 被实例化为专用目录中的一组文件,其中既包括静态组件(skill.md),也包括动态组件(上下文和数据 rollout)。元层优化和基础层优化都在具有标准工具集的 agentic coding 环境中执行:
Meta-Harness(Lee et al. 2026)又向更深处推进了一层:它的优化对象是这样一段代码,这段代码负责决定并优化哪些信息应该被保存、检索并呈现给模型。名称中的“Meta-”表示,它是一个用来优化 Harness 的 Harness。
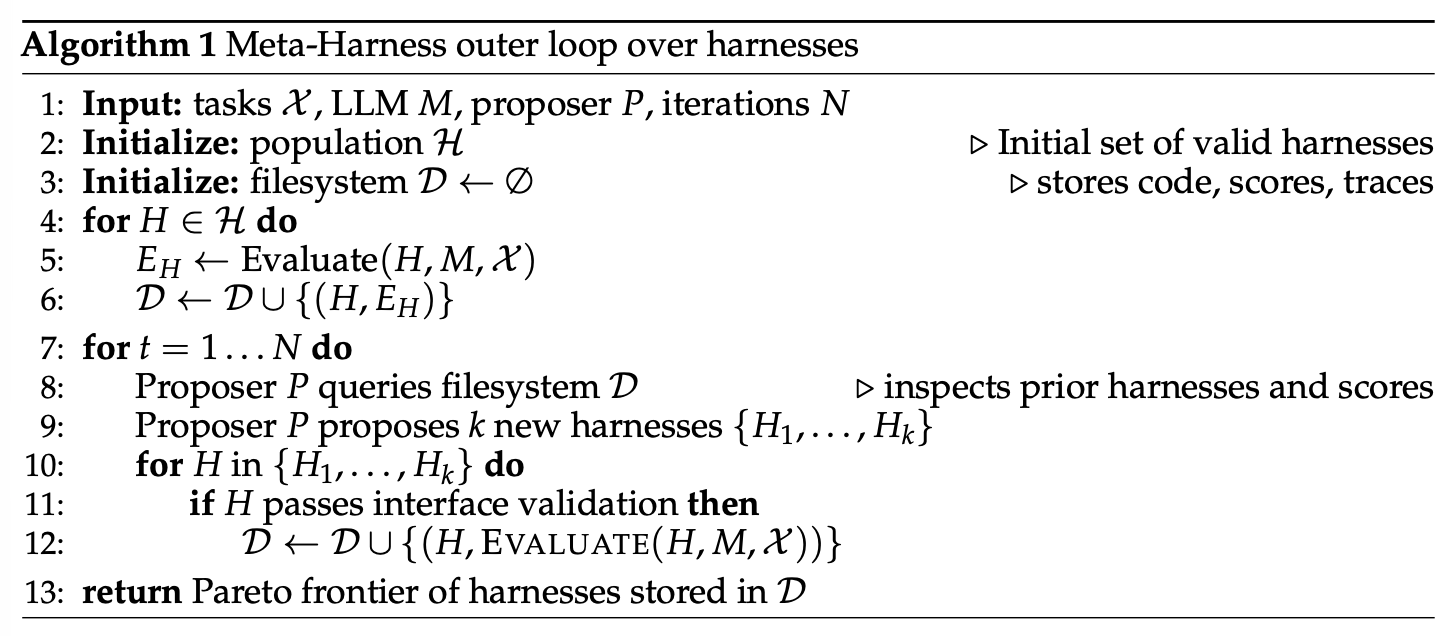
图 4:Meta-Harness 外循环优化算法。图片来源:Lee et al. 2026。
用于创建新 Harness 的 proposer 本身就是一个 coding agent,最终输出是位于 Pareto 前沿上的一组 Harness 候选。
- 全部执行历史都可以通过文件系统访问。因此,coding agent 会用
grep或cat等命令读取历史,而不是把所有内容都塞进单一提示词上下文。 - 被提出的 Harness 是文件系统中的一个目录,其中包含自己的源代码、分数、rollout 轨迹和状态更新。
- Meta-Harness 循环会迭代创建新的 Harness,只保留合格候选。
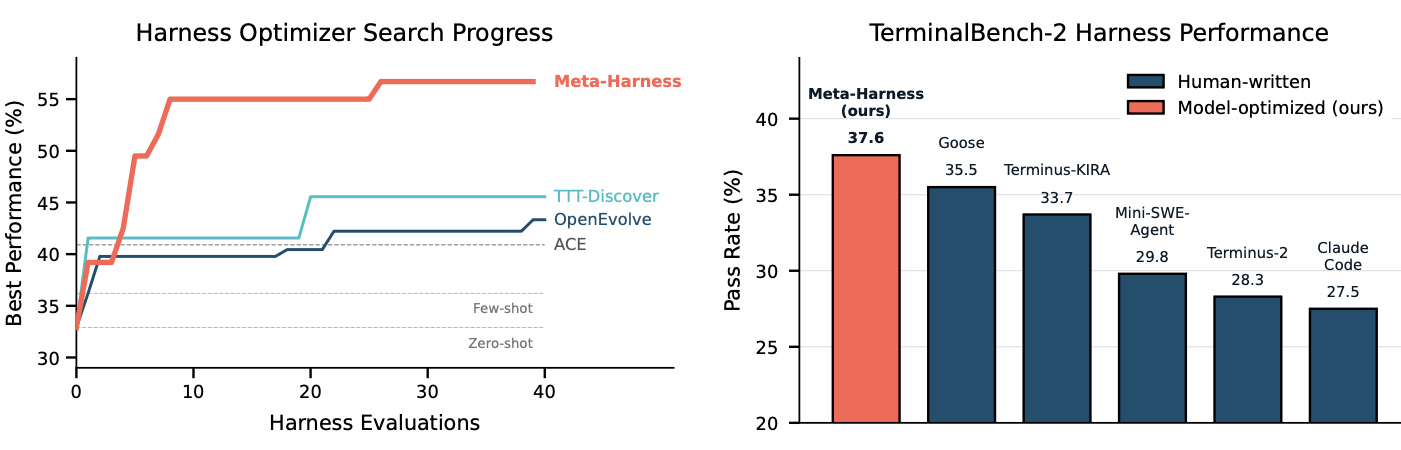
图 5:Meta-Harness 在少量迭代的文本分类任务(左)和 TerminalBench-2(右)上的表现。需要注意,TerminalBench-2 实验的搜索从 Terminus-KIRA 和 Terminus-2 初始化,这两个 Harness 本身都很强。图片来源:Lee et al. 2026。
不过,重要结论已经很清楚:一旦 Harness 设计变成一个可执行的搜索空间,强大的 coding agent 就能利用人类工程师所使用的同一片设计空间。
工作流设计
Harness 工程中的工作流可以由领域专家手工设计。以自动化研究为例,研究者已经提出并测试了多种框架。AI Scientist 系统(Lu et al. 2026)构建了一条流水线,用来提出研究想法、编写代码、运行实验、分析结果、撰写论文和执行同行评审。Meng et al.(2026)则在 ScientistOne 中把可验证性作为核心设计约束,要求每一项主张,无论是引用、数值、方法还是结论,都必须追溯到证据来源,并接受 Chain-of-Evidence 检查的审计。
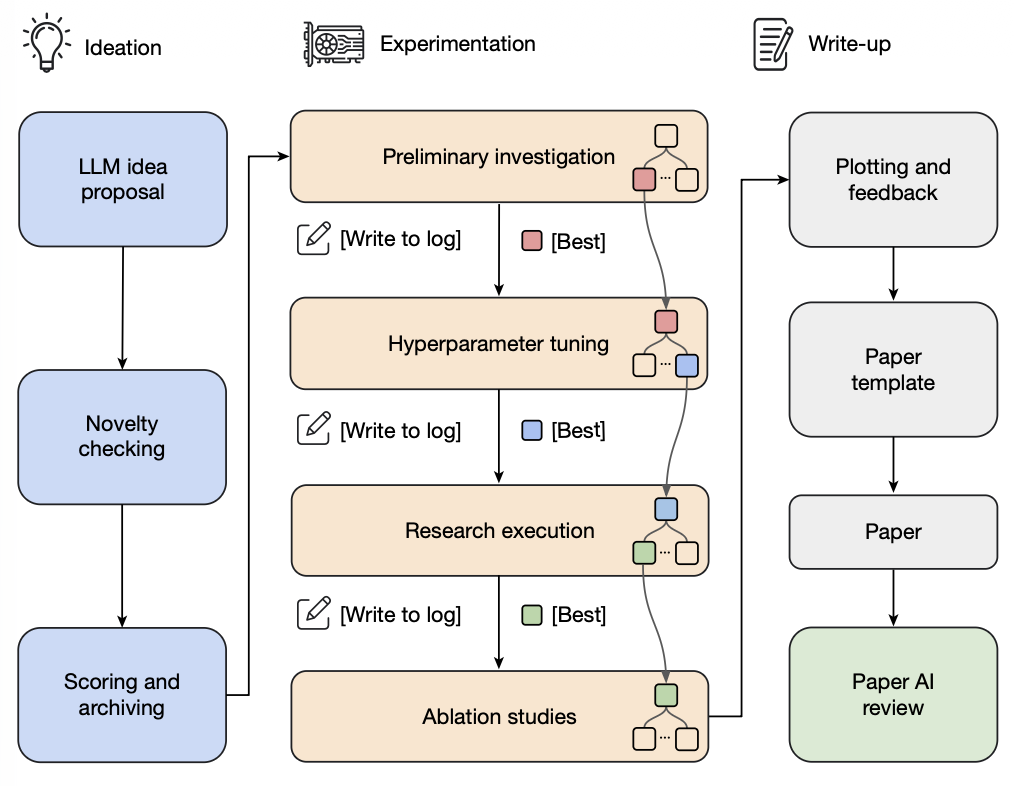
图 6:AI Scientist 用于想法生成、实验、论文撰写和评审的流水线。图片来源:Lu et al. 2026。
Autodata 智能体(Kulikov et al. 2026)被设计成一位生成训练和评估数据的数据科学家。主智能体管理四种角色:提出问题的 challenger、弱求解器、强求解器,以及 verifier/judge。目标是合成难度“恰到好处”的数据,即强求解器能够成功,而弱求解器会失败。
在 Autodata 中,challenger 的提示词会根据求解器和 verifier 的反馈迭代更新。这里的限制是,合成任务被用来微调弱求解器,而不是强求解器。如果循环无法持续改进强模型,它就更像是在生成的提示分布上进行间接蒸馏,RSI 的意味会弱一些。
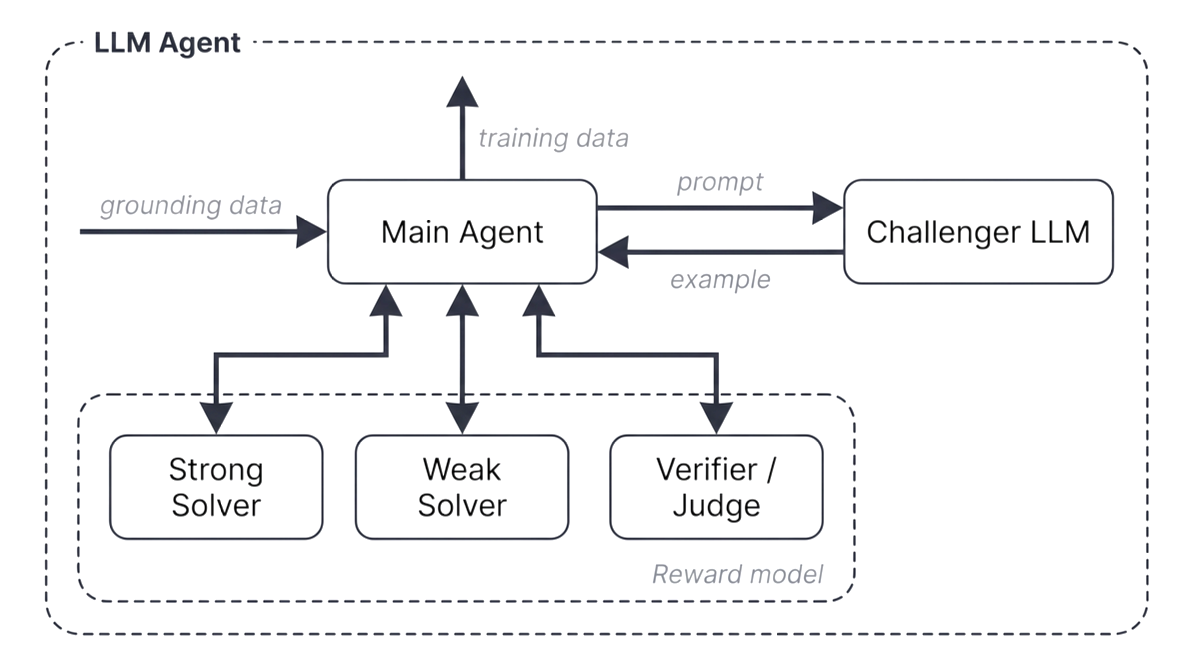
图 7:Autodata 的 agentic 工作流,围绕 challenger、solver 和 verifier 等角色生成合成训练与评估数据。图片来源:Kulikov et al. 2026。
工作流的设计空间非常庞大。我们很自然地可以把工作流设计看成一个搜索问题,从而期待算法能够找到良好方案,而不必完全依赖人工设计。沿着这个方向,Automated Design of Agentic Systems(ADAS;Hu et al. 2025)把智能体设计本身表述为优化问题,并提出“meta-agent search”,由元智能体提出新的 agentic 工作流设计。
- 用 CoT、self-refine 等简单智能体初始化 agentic 工作流 archive。
- 让元智能体参考 archive 中的已有方案,用代码编写新的智能体。
- 元智能体先生成新工作流的高层描述,再用代码实现。
- 随后,元智能体对程序草稿执行两次 self-refine:先让模型给出反馈,再让同一模型根据反馈改进先前输出(Madaan et al. 2023),同时检查其新颖性。
- 评估每个新候选,把成功的方案加入 archive。
- 重复步骤 2 至 3,直到达到最大迭代次数。
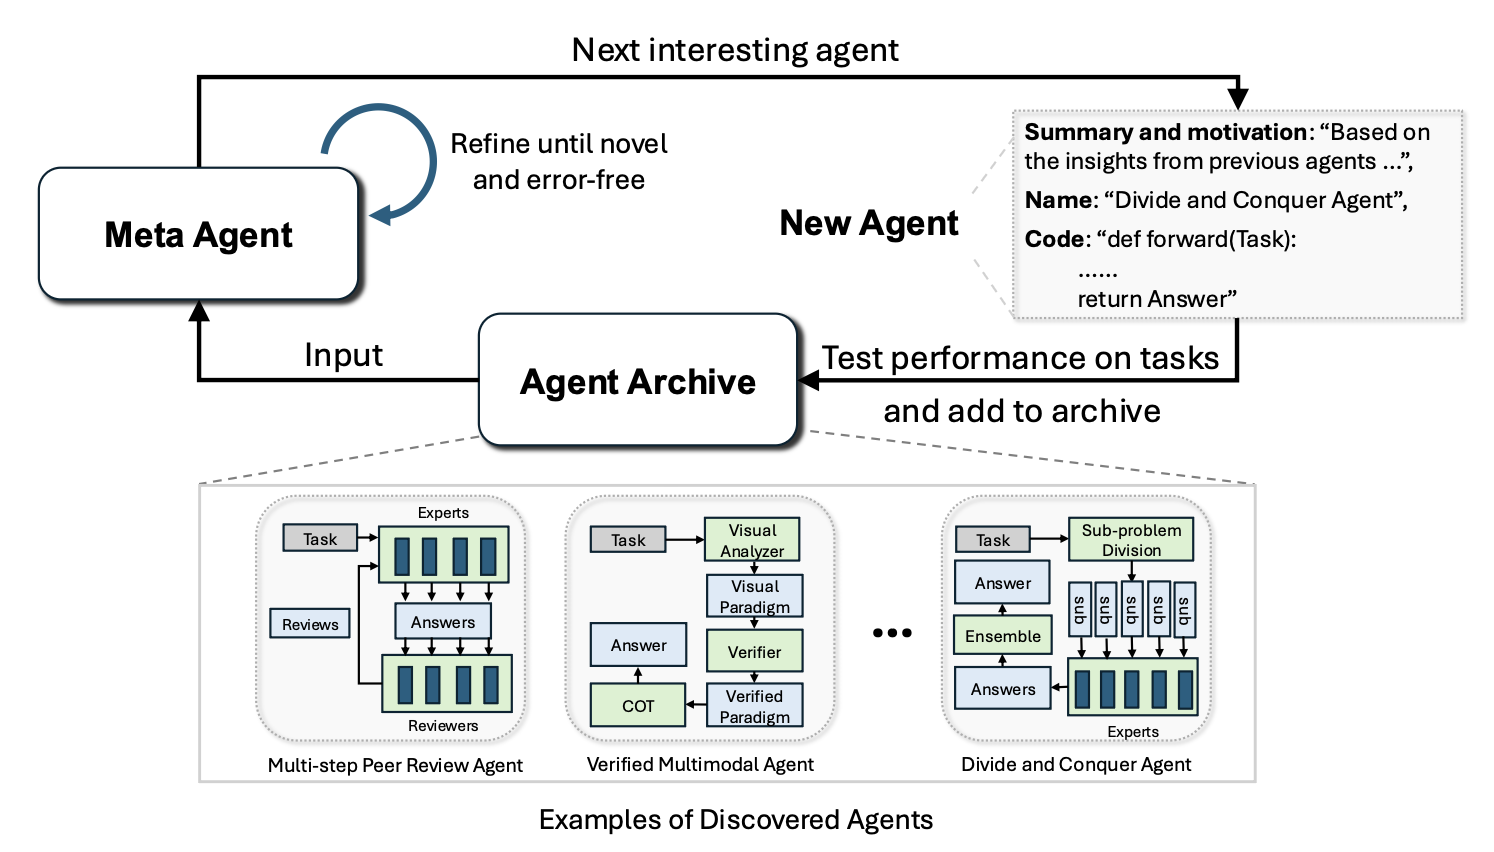
图 8:Automated Design of Agentic Systems(ADAS)示意图。图片来源:Hu et al. 2025。
AFlow(Zhang et al. 2025)把 agentic 工作流表示为一张图,其中节点代表调用 LLM 的动作,边则用代码实现逻辑操作。工作流优化依赖 MCTS,即蒙特卡洛树搜索:
- 使用模板,在搜索树中初始化起始工作流 $W_0$。
- 使用得分与均匀探索的软混合策略,选择一个工作流节点。
- 根据该节点的评估表现,让 LLM 生成修改后的工作流来扩展节点。
- 执行并评估新的工作流。
- 如果新工作流在 $N$ 轮预算内表现出改进,就把它加入搜索树。
- 重复步骤 2 至 5;当 top-$k$ 平均分进入平台期,或预算耗尽时停止。
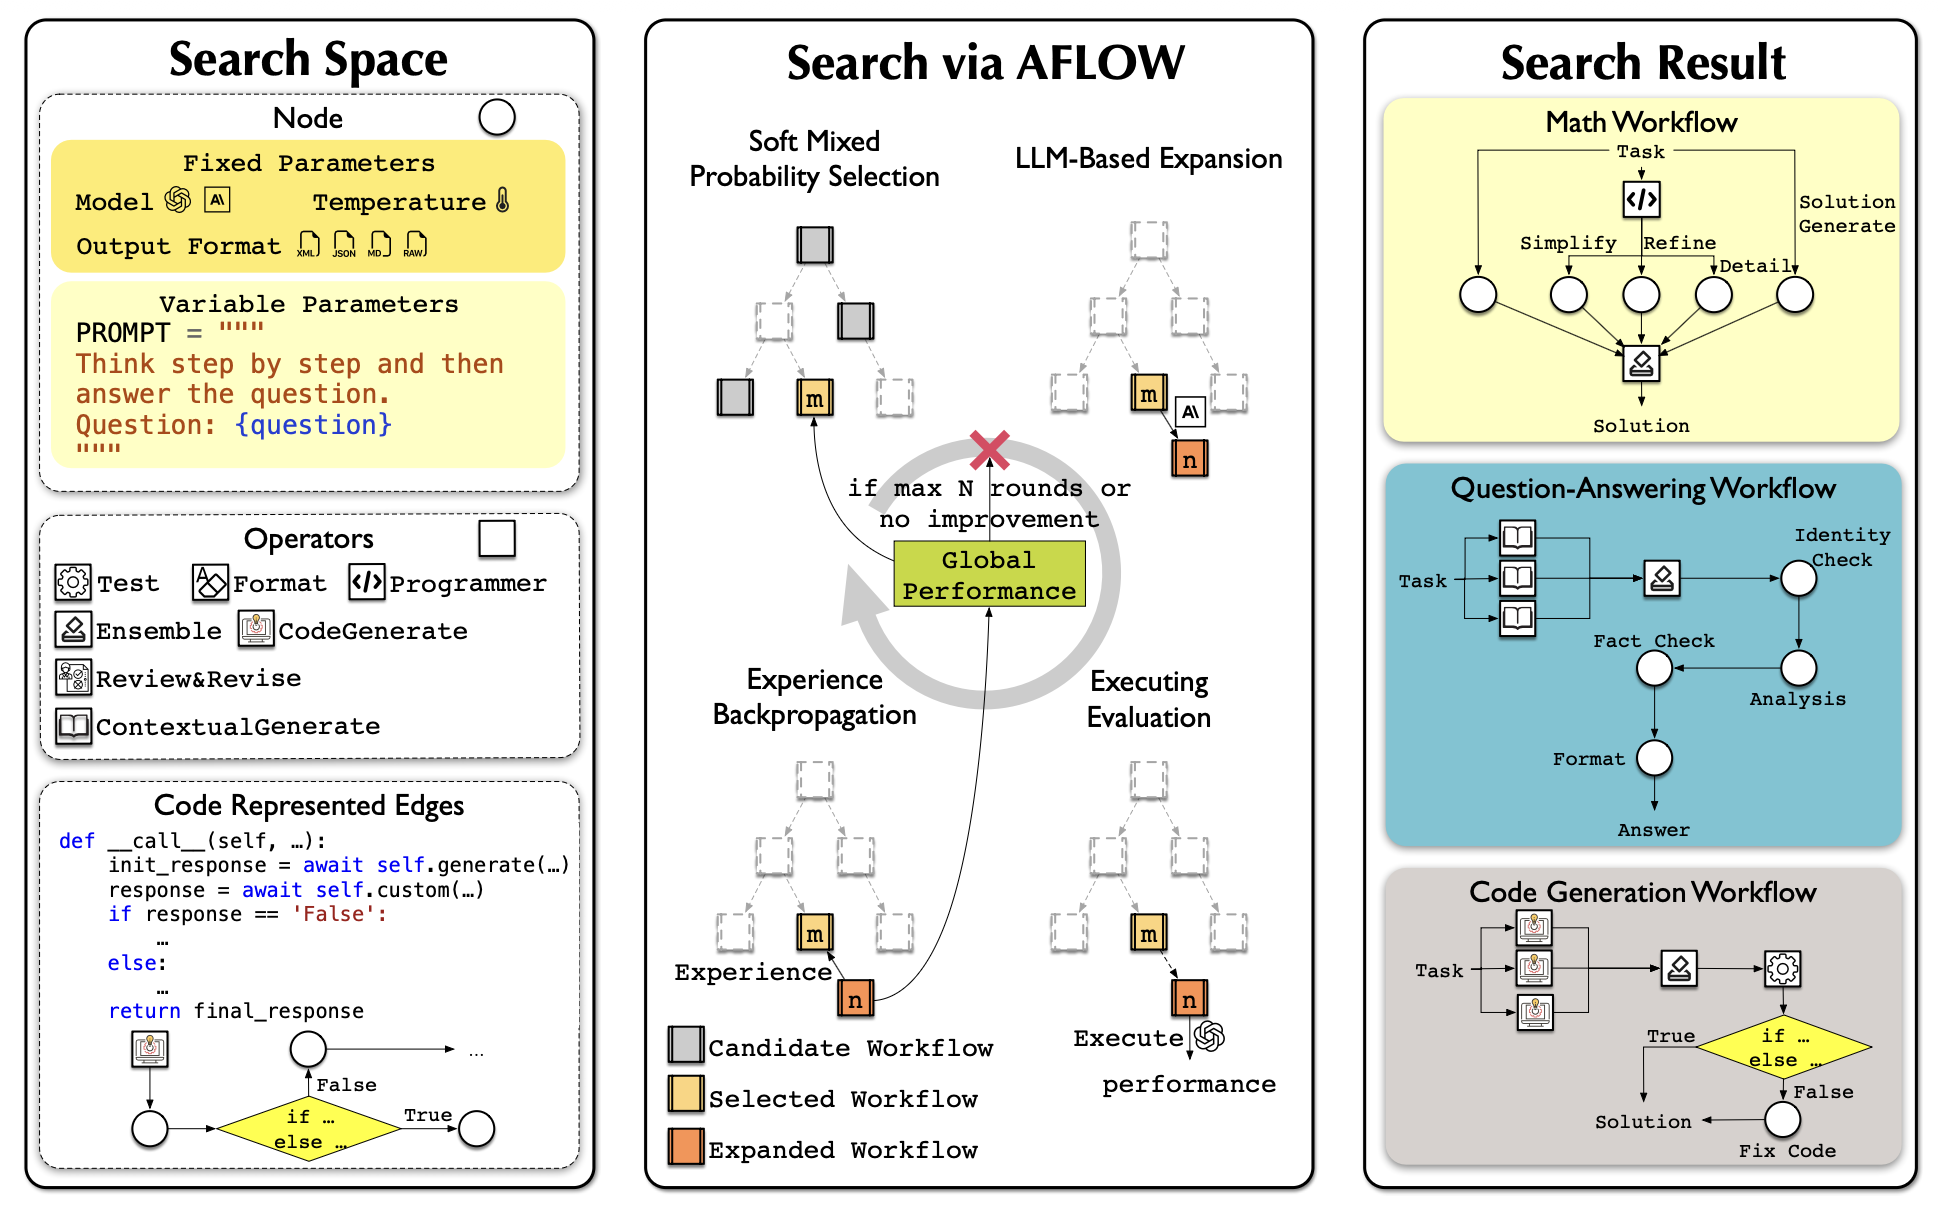
图 9:AFlow 在工作流候选树上的优化过程。图片来源:Zhang et al. 2025。
AFlow 在问答、代码和数学任务上的实验表明,与人工设计工作流和 ADAS 相比,AFlow 取得了相当不错的提升。
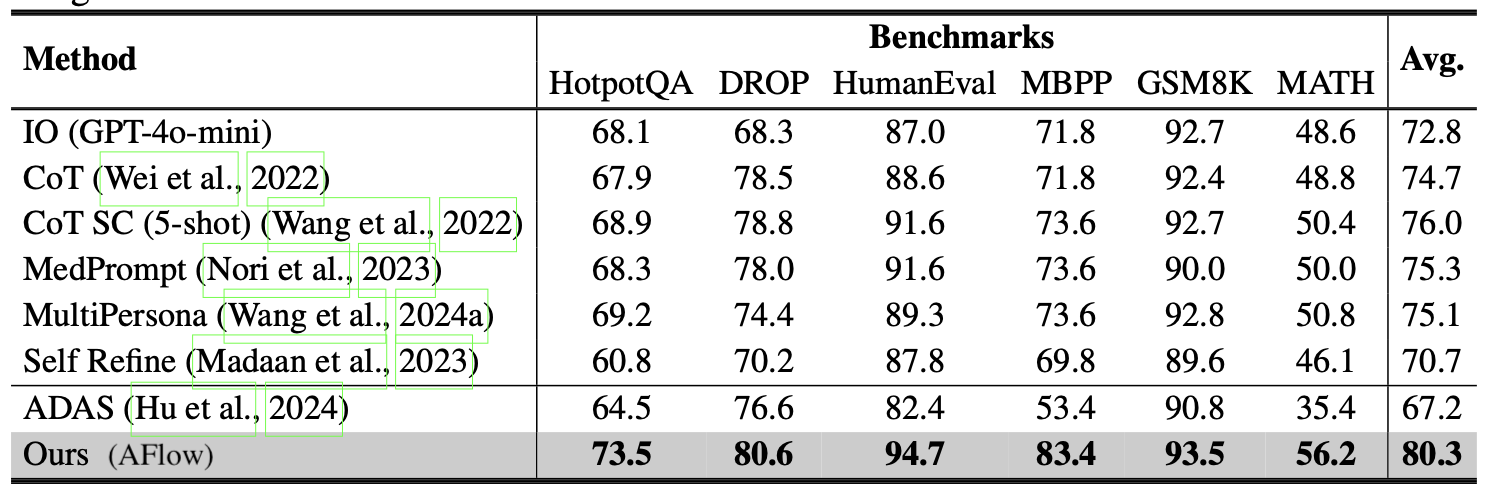
图 10:AFlow 与人工方法及 ADAS 的实验对比。图片来源:Zhang et al. 2025。
自我改进的 Harness
上下文工程和工作流设计都只是 Harness 的一部分。我们需要搜索完整设计空间,同时优化上下文管理逻辑、工作流、权限以及许多其他 Harness 组件。正如 Meta-Harness、ADAS 和 AFlow 等工作所展示的那样,✨代码✨是定义程序与系统的通用语言。简单来说,Harness 就是一段代码,它规定提示词、工具调用、子智能体、控制流、记忆和工作流逻辑如何协同工作。如果 LLM 能优化执行智能体的代码,它所能进入的设计空间就会比手写提示词大得多。
Self-Taught Optimizer(STOP;Zelikman et al. 2023)是递归式 scaffold 改进的早期例子之一。在 $t=0$ 时,种子改进器 $I_0$ 接收初始解 $s$、效用函数 $u$ 和黑盒语言模型 $M$,并返回改进后的解 $s’$,即 $s’=I(u,s;M)$。STOP 的目标并不是直接改进 $s$,而是改进改进器 $I$ 本身。
首先,把给定改进器函数 $I$ 在一组下游任务 $\mathcal{D}$ 上的平均效用定义为元效用:
\[\hat{u}(I) \triangleq \frac{1}{\vert\mathcal{D}\vert}\mathbb{E}_{(u,s)\sim\mathcal{D}}[u(I(u,s;M))].\]改进“改进器函数”本身也是一个优化问题。因此,我们可以根据元效用测得的 $I_{t-1}$ 表现,通过一次自我改进更新,递归地获得新版 $I_t$:
\[I_t=I_{t-1}(\hat{u},I_{t-1};M).\]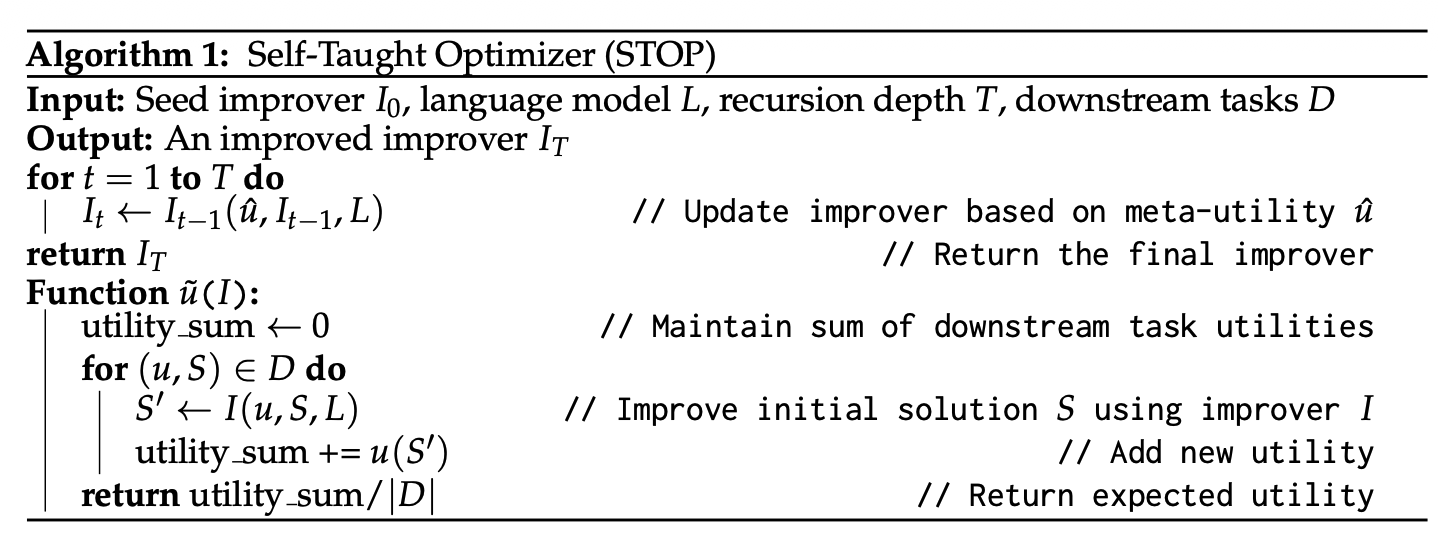
图 11:Self-Taught Optimizer(STOP)算法。图片来源:Zelikman et al. 2023。
在实验中,改进后的改进器发现了多种策略,包括遗传算法、分解并改进各个部分、多臂提示词 bandit、模拟退火、改变温度,以及 beam/tree search。这与把 Harness 工作流表示成优化对象的做法相似。
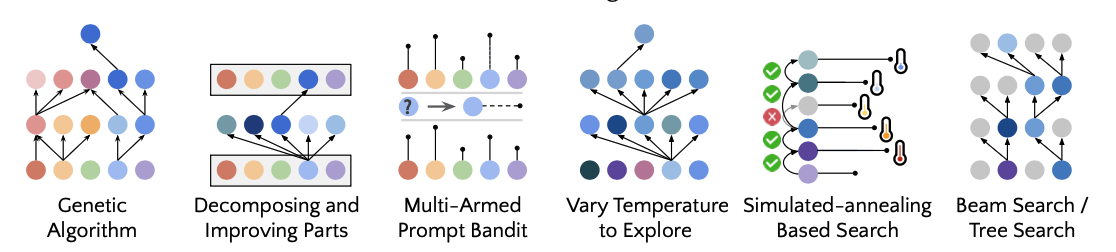
图 12:STOP 发现的自我改进策略示例。图片来源:Zelikman et al. 2023。
Zelikman et al.(2023)的结果中还有一项值得警惕的发现:使用 GPT-4 时,STOP 让平均下游表现随迭代提升;换成 GPT-3.5 和 Mixtral 等较弱模型后,表现却变差了。递归结构本身并不够。基础模型必须具备足够能力,才能改进这套机制。这意味着 Harness 改进可以让模型部署得更好,但智能本身依然是核心。
Lin et al.(2026)更细致地研究了 Harness 演化对模型能力的依赖。他们把问题拆成两个维度:一是 harness-updating,指产生有用 Harness 编辑的能力;二是 harness-benefit,指利用更新后的 Harness、更好地解决任务的能力。实验观察到,从 Qwen3.5-9B 到 Claude Opus 4.6,一系列具有不同规模和核心智能的模型,可能表现出相近的 Harness 更新能力;9B Harness proposer/evolver 写出的 skill,在程序结构上可以与 Opus 同构。要把 Harness 用好,模型仍需正确、及时地调用 skill 和工具,也要擅长长周期指令遵循。
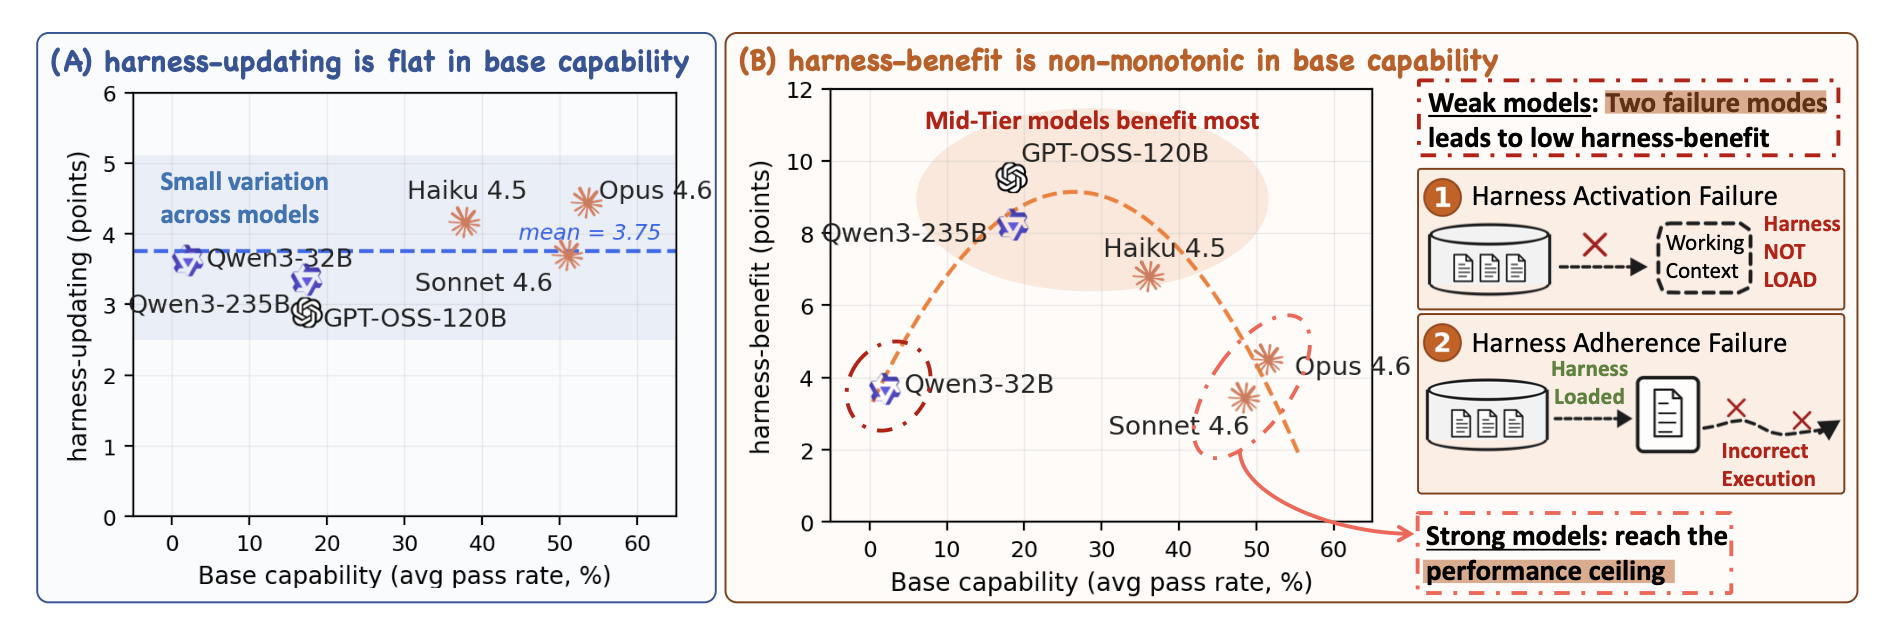
图 13:主要结果。(A)从 Qwen2-32B 到 Opus 4.6,不同模型的 Harness 更新能力大致持平;(B)Harness 受益能力呈非单调关系,中等层级模型获益最大。图片来源:Lin et al. 2026。
一项更近的工作 Self-Harness(Zhang et al. 2026)依靠 LLM 智能体,通过“提出、评估、接受”循环来改进自己的 Harness。
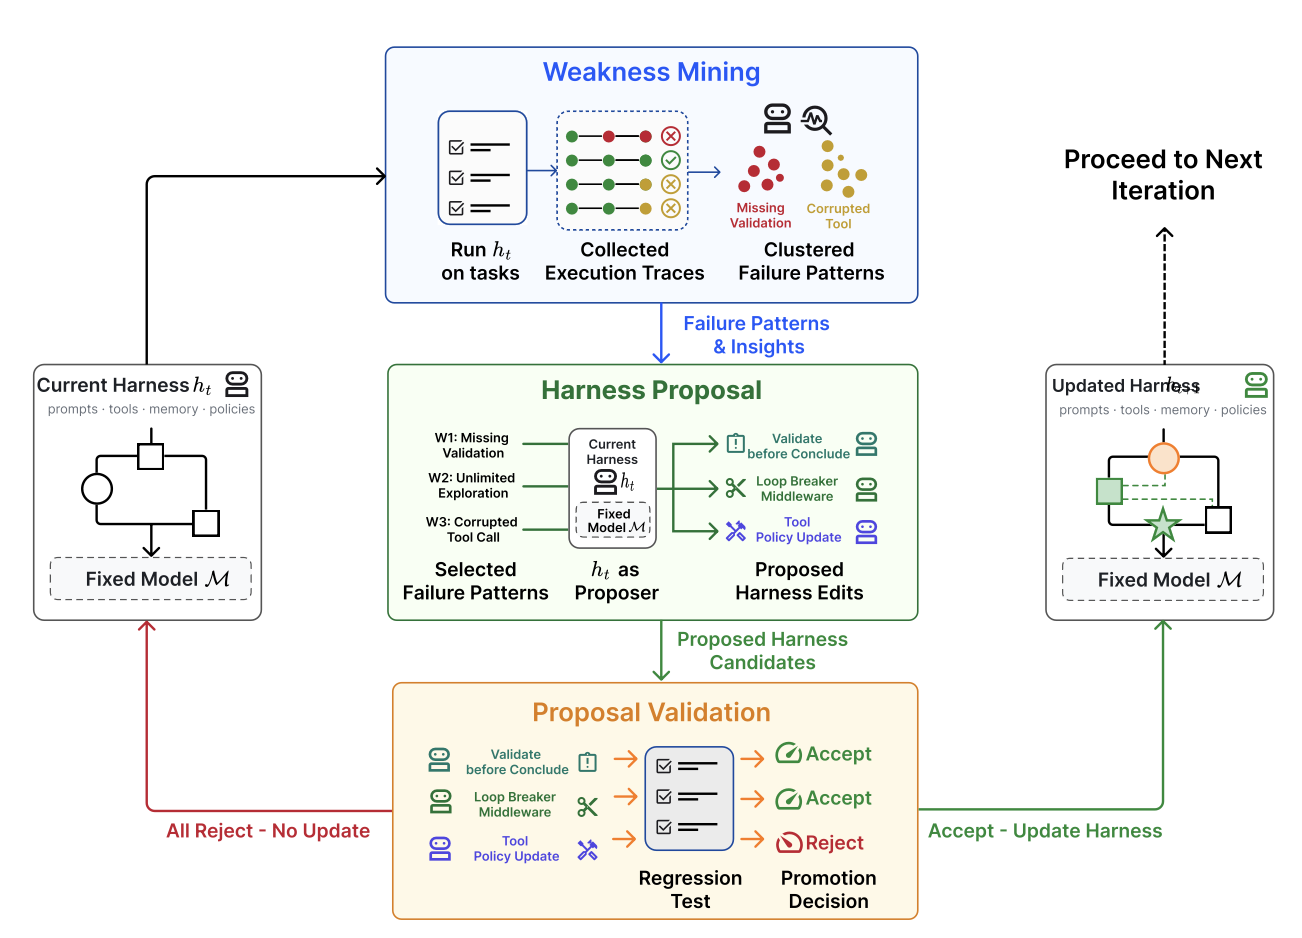
图 14:Self-Harness 使用弱点挖掘、有限范围的 Harness 提案和验证循环来更新 Harness。图片来源:Zhang et al. 2026。
Self-Harness 循环包含三个阶段:
- 弱点挖掘:把失败聚类成由 verifier 证据支撑的失败模式。
- 使用当前 Harness $h_t$ 在任务上进行评估,并收集执行轨迹以供分析。
- 两次运行在错误日志的表面上可能拥有相同的 verifier 结果,例如都表现为超时或缺失制品,但背后的因果机制不同。因此,需要记录信息丰富的失败案例,包括 verifier 层的终止原因、相关智能体行为的因果状态,以及轨迹暴露出的抽象智能体机制,从而找出根因。
- Harness 提案:根据挖掘到的失败模式,提出范围有限的 Harness 编辑。
- 在 $h_t$ 下调用同一个模型作为 proposer。
- 给模型提供有界的提案上下文:(1)当前 Harness 可编辑的表面;(2)评估系统给出的、由 verifier 证据支撑的失败模式;(3)应该保留的通过行为记录;(4)过去尝试过的编辑摘要。
- Harness 编辑应优先处理反复出现、可被解决的错误模式,例如不是任务自身难度导致的问题,而且能够通过小范围修改来解决。
- Harness 编辑候选应彼此不同并保持多样性。
- 提案验证:验证并合并合格编辑,得到新 Harness $h_{t+1}$。
- 使用 held-in 数据 $D_\text{in}$ 和 held-out 数据 $D_\text{out}$ 对候选编辑执行回归测试。前者检查目标弱点是否解决,后者检查是否引入其他未知问题。
- 只有当候选在 held-in 与 held-out 数据上都没有回归时,才会被接受。
- 被接受的候选会合并到 Harness,形成 $h_{t+1}$;被拒绝的候选只写入日志,不改变当前活动 Harness。
在 Terminal-Bench-2 上运行 MiniMax M2.5、Qwen3.5-35B-A3B 和 GLM-5 时,Self-Harness 学到了针对不同基础模型弱点的模型特定 Harness 指令,并提高了 held-out 通过率。
Self-Harness 这类工作也让我产生了一项担忧:如果允许一个程序编辑操作系统,抽象边界就被打破了。可编辑表面需要经过恰当设计,权限控制和安全层则必须位于这个循环之外。与奖励劫持有关的所有挑战依然存在。
Agentic Harness Engineering(AHE;Lin et al. 2026)认为,Harness 演化的瓶颈在于可观察性。也就是说,当一次 rollout 失败时,我们需要知道应该由哪个组件负责,而且每一项编辑都必须有证据依据。
这个框架用三项可观察性支柱构成闭环:
- 组件可观察性:每个可编辑 Harness 组件都在文件系统中拥有一种表示,让动作空间显式、可追踪。
- 一个 Harness 包含七类组件:system prompt、tool description、tool implementation、middleware、skill、sub-agent configuration 和 long-term memory。
- 每种失败模式都会映射到一个组件,让编辑更有针对性。
- 经验可观察性:把大量原始轨迹分析并汇总成层次化的证据与失败模式。
- 每个 Harness 生成 $k$ 条轨迹。
- 使用一个称为“Agent debugger”的智能体分析每条分别保存在文件中的轨迹,并为每项任务生成分析报告,说明失败或成功的根因。
- 所有逐任务报告会汇总成 benchmark 概览,供下一阶段使用;需要时仍可访问原始轨迹。这种分层访问结构更节省 token。
- 决策可观察性:每项编辑都附带一条可以在下一轮验证的预测。
- 一个称为“Evolve agent”的智能体读取仓库,决定编辑哪个组件,然后给出编辑以及背后的推理。
- 每项编辑都是文件级、可证伪的主张,可以在下一轮验证,同时受两项约束:
- 编辑只能应用于 Harness 工作区。运行目录、tracer、verifier 和 LLM 配置是只读的。这样可以阻止一组奖励劫持做法,例如禁用 verifier、替换模型或提高推理预算,从而让每项记录到的增益都可以归因于 Harness 编辑。
- 编辑必须由证据驱动,并附带一条 manifesto 记录:失败证据的名称、推断出的根因、针对性的修复,以及预测影响。预测影响既包括预期修复,也包括存在风险的回归。
在 Terminal-Bench-2 上,除 Hard 层级以及少数自演化基线(ACE、TF-GRPO)外,AHE 的表现优于人工设计的 Harness(OpenCode、Terminus-2、Codex)。同一个冻结后的 Harness 在不继续演化的情况下,还能迁移到 SWE-bench Verified。这说明演化出的 Harness 能把工程经验编码进 Harness 组件,而不只是针对特定 benchmark 做优化。
演化搜索
演化搜索是一种受自然选择启发的优化方法,参见我过去关于演化算法的文章。它通过变异来演化一组候选解,并只保留群体中“适应度”较高的方案。当搜索空间非常庞大或形状不规则,而且难以直接用梯度优化、却容易评估候选解时,演化搜索会很有用。Harness 搜索似乎很适合这种方法。
过去的研究已经把演化搜索用于提示词工程。Promptbreeder(Fernando et al. 2023)通过丰富的变异操作优化任务特定提示词。有趣的是,mutation prompt,也就是指导 LLM 变异任务提示词的指令,本身也通过演化得到改进。GEPA(Agrawal et al. 2025)把基于反思的提示方法与演化搜索结合起来,通过对反复试错轨迹进行自然语言反思,提出提示词更新。
Novikov et al.(2025)提出 AlphaEvolve,把它设计为一个基于 coding agent 的演化搜索系统。系统保存一个候选程序池,并提示冻结权重的 LLM 生成用于改进的 diff。它会反复评估子程序并保留成功方案,随着时间推进逐步发现更好的解。
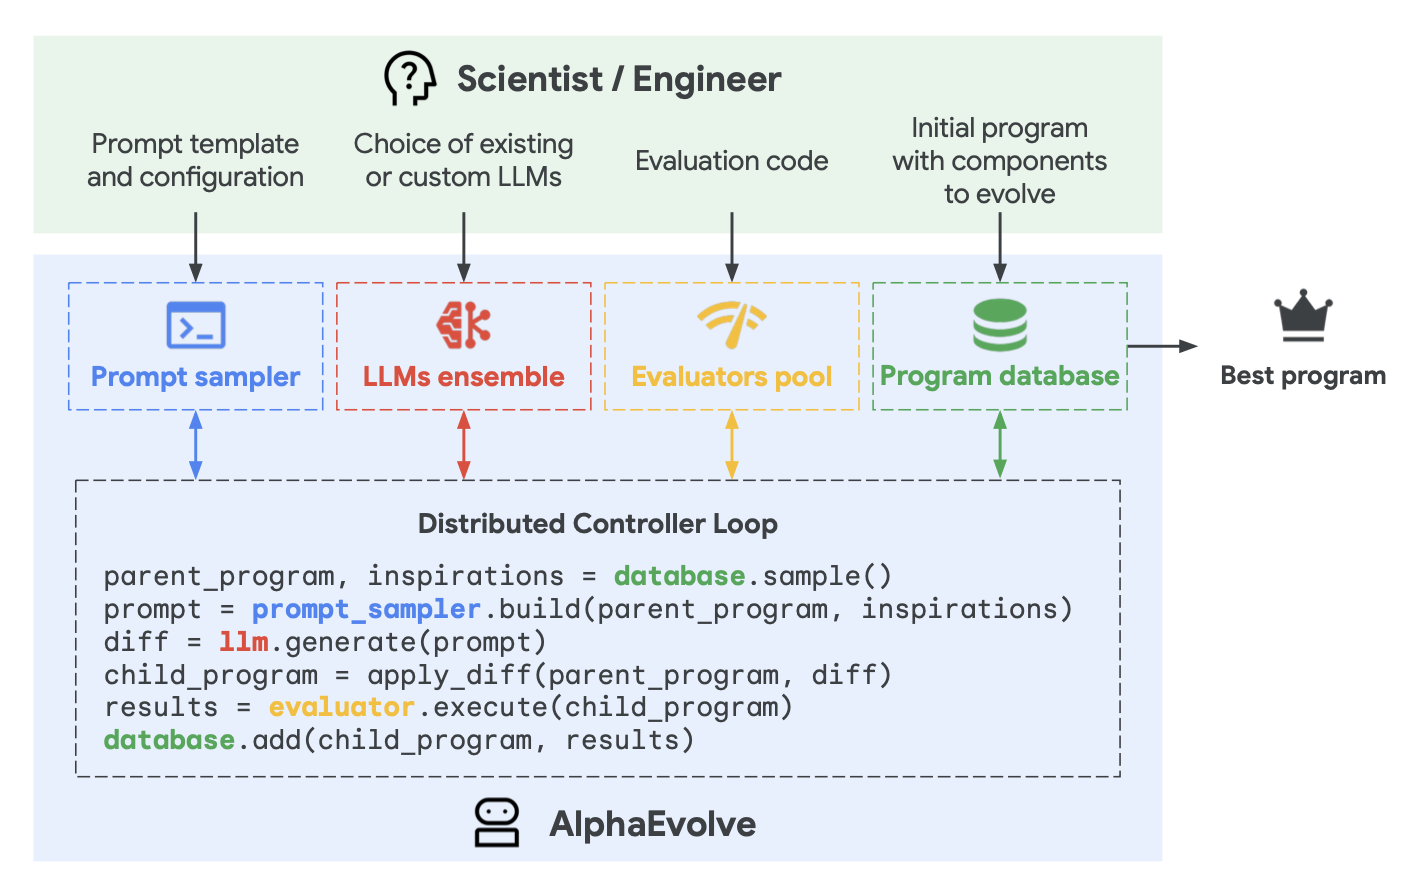
图 15:AlphaEvolve 的工作方式。图片来源:Novikov et al. 2025。
AlphaEvolve 的设计中有几个重要细节:
- 提示词包含父程序、结果、指令,有时还包含元信息。
- Coding agent 可以访问完整仓库,但可改进的代码区域会使用
# EVOLVE-BLOCK-START和# EVOLVE-BLOCK-END显式标记。 - 元提示词会按照 LLM 的建议,与指令和上下文共同演化,这与演化候选程序的方式相似。
消融实验展示了演化过程、提示词中的上下文、元提示词、整文件演化以及使用更强 LLM 的价值。
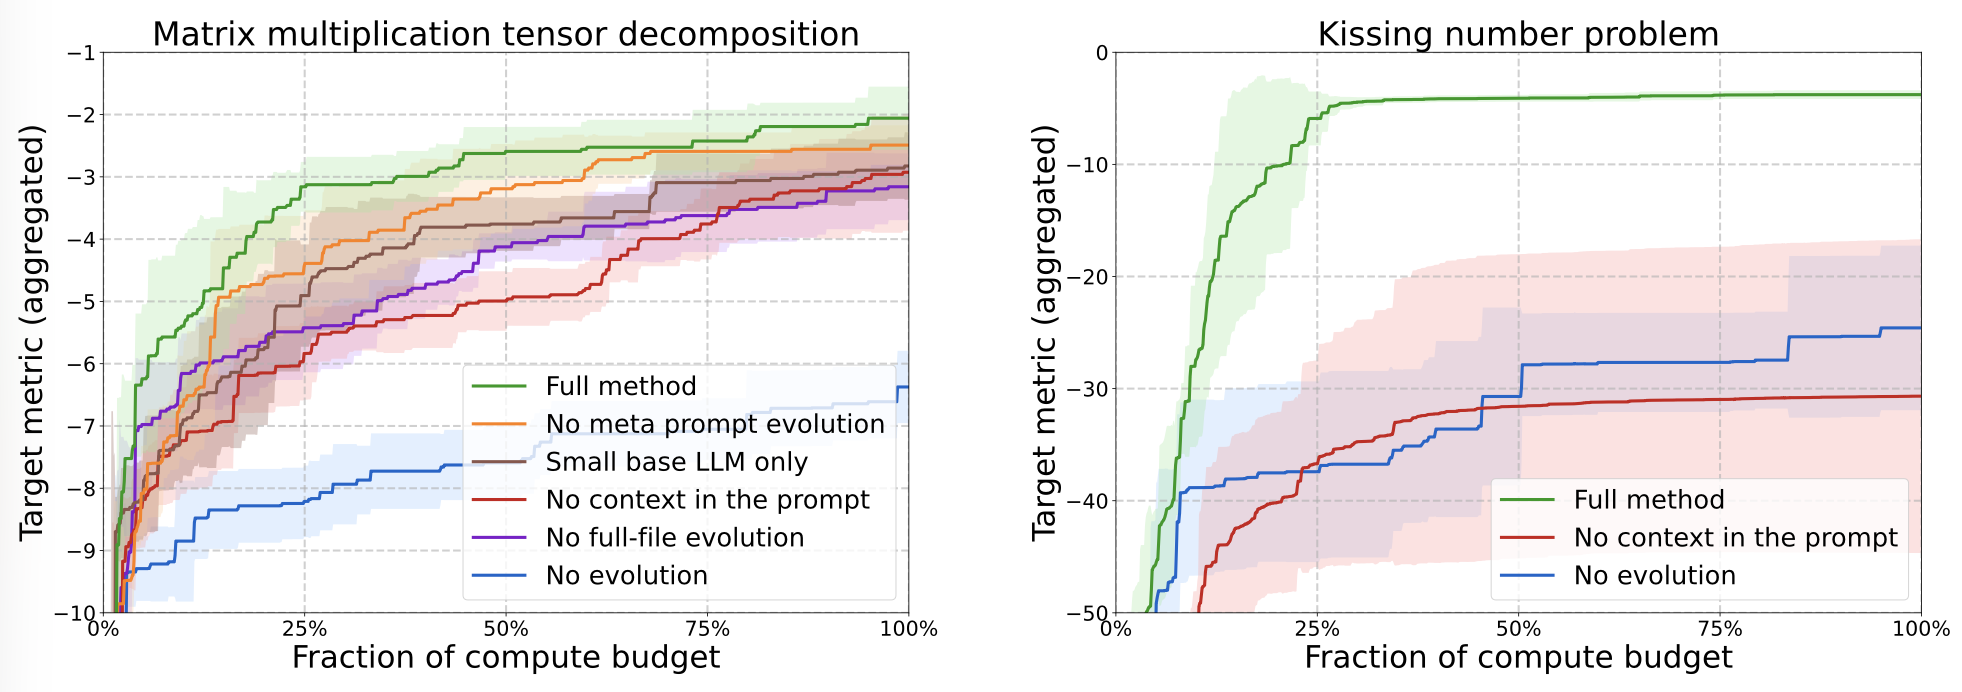
图 16:消融实验展示 AlphaEvolve 多项设计的价值。图片来源:Novikov et al. 2025。
近期的一些变体也沿着这个方向发展。ThetaEvolve(Wang et al. 2025)把演化搜索与强化学习、上下文学习结合起来;DemoEvolve(Che et al. 2026)则在自 rollout archive 中加入人类专家示范,把它们作为 Harness 层诊断和编辑的参考经验。另一方面,ShinkaEvolve(Lange et al. 2025)加入了三个新组件来提高 LLM 采样效率:
- 设计 parent sampling,在性能排名和后代数量之间取得平衡,从而提高探索的样本效率。
- 基于 embedding 的余弦相似度,丢弃与现有种群过于相似的候选,执行代码新颖性拒绝采样。
- 在 meta-scratchpad 中识别成功方案的良好模式,用来指导后续变异。
上述方法主要关注候选解本身的改进;与它们不同,Darwin Gödel Machine(DGM;Zhang et al. 2025)明确以可编辑的 Harness 代码仓库为演化目标,并使用基于 LLM 的 coding agent 来执行演化。准确地说,这个智能体可以修改自己的 Harness。后续工作 Hyperagents(Zhang et al. 2026)又引入一个元智能体,控制如何修改现有任务智能体来创建新智能体。
- 从候选池中的一个 coding agent 开始。
- 每轮迭代中,选择一个 parent 进行修改并产生分支。选择概率与其性能成正比,与其已有子代数量成反比。
- 被选中的 parent 智能体检查自己的 benchmark 评估日志,然后提出对自身 Harness 代码库的改进,生成新版 coding agent。代码编辑通过两个基础工具实现:(1)bash,参数为
<bash_command>;(2)editor,参数为view/create/edit <file_path>。 - 评估新的 coding agent,只有表现足够好的候选才会加入候选池。
- 重复步骤 2 至 4,直到命中某个停止条件。
DGM 是固定模型条件下的 Harness 演化。在实验中,以 Claude 3.5 Sonnet 作为基础 LLM,并从简单的初始 Harness 配置开始,DGM 发现的智能体在 SWE-bench Verified 上从 20% 提升到 50%,在 Polyglot 上从 14.2% 提升到 30.7%,表现达到或超过人工设计的智能体。
当候选解可以自动评估、候选适应度容易量化时,这类方法表现很好,例如矩阵乘法、GPU kernel 优化、算法竞赛和数据中心调度。如果一个领域的评估很慢、含义模糊,或者主要依赖启发式判断,它们就会遇到困难。演化过程的计算效率和实际效果同样值得关注。
与模型权重联合优化
Harness 演化改变的是模型周围的非参数系统。为了实现完整的自我改进,也可以允许模型同时更新自己的权重。权重更新可以通过改进模型训练流水线来实现,也可以通过测试时持续学习实现。持续学习值得以后单独写一篇文章讨论。
SIA(Hebbar et al. 2026)是把 Harness 改进与模型参数更新放进同一优化循环的早期尝试。它包含三个组件:
- Meta-Agent:提出初始 Harness。
- Task-Specific Agent:执行任务。
- Feedback-Agent:根据近期轨迹,决定应该更新 Harness 还是更新模型权重。
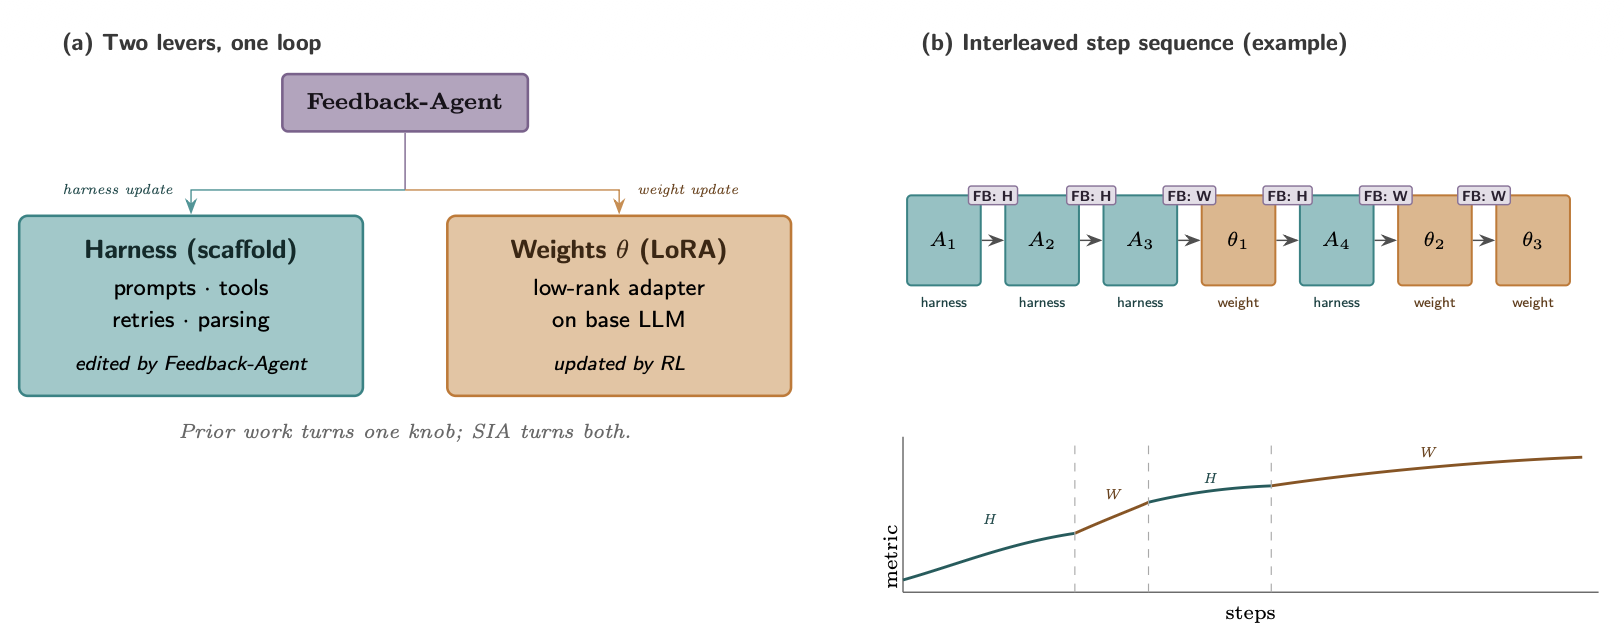
图 17:SIA 中的 Feedback-Agent 决定下一轮迭代类型。图片来源:Hebbar et al. 2026。
SIA 的实验中存在一些混杂选择,使结果难以解释。例如,任务特定智能体远弱于 Meta-Agent 和 Feedback-Agent 使用的模型,即 gpt-oss-120b 对比 Claude Sonnet 4.6;基线也太弱,难以与相关方法进行干净的交叉比较。我认为这个方向很有意思,但现有证据仍是初步的。训练稳定性和 Goodhart 效应等许多挑战也依然没有解决。
Continual Harness(Karten et al. 2026)则在长周期游戏环境中进行了实验:系统一边更新 Harness,一边利用强教师模型在低奖励轨迹上给出的标签进行蒸馏,共同学习一个策略模型。
未来挑战
AI Scientist 这一研究路线有力地展示了:专家设计的 Harness 可以协调自动化研究循环中的很大一部分工作,当前实验主要采用写研究论文的形式。但论文生产不等同于科学发现。一个系统可以写出看似可信的论文,同时仍然包含虚构引用、实现漂移或薄弱的实验结果。
Trehan 与 Chopra(2026)测试了 LLM 能否在极少 scaffold 和基础工具的条件下,从研究想法一路完成论文;这些工具包括 read_file、write_file、llm_search 和 list_files。每个想法都有一个专用工作区,智能体可以在其中生成并读取文档,把它们作为上下文的一部分。实验覆盖三个领域:世界模型、多智能体强化学习,以及 AI 安全与对齐;每个领域都包含 45 至 50 份高质量种子文档,用来启发新想法。
人类专家只选出四个想法进入完整流水线,最终只有一个被完整执行并形成论文。实验中反复观察到六种失败模式:
- 偏向训练数据中的默认做法:使用旧库、过时命令、标准格式,或者采用没有扎根于当前仓库或数据集的假设。
- 执行压力下的实现漂移:当实现变得复杂时,模型可能退回一种常见而简单的方案,而不再实现原先提出的方法。
- 记忆和上下文退化:除非把日志写成持久制品,长周期项目会丢失关键细节。
- 过度乐观:即使实验噪声很大或已经失败,模型仍会宣布成功。这与 Bubeck et al.(2025)观察到的“p-hacking and eureka-ing”模式相似,模型可能加入“数值胶带”,在信号仍是噪声时就宣布胜利。
- 领域智能不足:模型缺少隐性的实践知识,例如预测实现复杂度、判断实验结果是否合理,或知道哪些基线真正重要。
- 科学品味薄弱:实验也许可以执行,却没有回答正确的问题。
研究者在走向完整 RSI 的道路上已经取得了真正的进展,但仍有几个瓶颈。
1. 评估器薄弱且模糊。 许多研究主张都没有快速而精确的 verifier,许多真实世界任务也一样。当前自我改进循环最适合评估指标可测量、客观的任务,这与强化学习的工作方式相似。
研究品味、新颖性和长期科学价值要难测量得多。例如,研究品味通常混合了问题构造、实验设计,以及对两类问题的判断:哪些意外结果值得追踪,哪些失败案例值得重试。
2. 上下文和记忆的生命周期。 随着 AI 智能体越来越自主和独立,记忆也会持续增长。一个有效的 Harness 需要管理上下文和记忆,以弥补现有长上下文生成的局限,同时尽可能提高长周期任务的成功率。人类能够在整个一生中维持记忆,我在这里看到了一种类比:上下文工程将会、也应该成为智能的核心组成部分,而不只是停留在软件系统层。
3. 负面结果。 研究者受到激励,更愿意发表成功结果,因此文献天然偏向成功。LLM 在海量数据上训练,这些数据至少目前仍主要由人类创造,哈哈;由于数据中成功与失败案例不平衡,模型可能不善于决定何时放弃假设、报告负面结果,甚至承认失败。研究 Harness 应让保存失败尝试变得容易,因为从失败中学习,是缩小任务搜索空间的最佳方式。
4. 多样性坍缩。 演化循环和强化学习循环往往会利用已知的高奖励模式。我们需要相应的机制,防止候选种群坍缩成同一种方案的多个变体。这一点对开放式研究尤其重要,因为最佳路径在当前评估器下可能一开始显得更差。
5. 奖励劫持。 自我改进循环会优化它所获得的任何信号。如果奖励来自单元测试,智能体可能过拟合测试;如果奖励来自 judge model,它可能学会针对这个 judge 的奖励劫持技巧;如果奖励来自 benchmark 分数,它可能利用 benchmark 中的伪影。
评估器和权限控制很可能应该放在演化 Harness 的循环之外,并在关键决策点使用 held-out 测试、轨迹审计和人类评审。监督能够扩展和自动化到什么程度,仍然是一个开放研究问题。
6. 长期成功。 外部优化循环会处理单次 rollout 之外的奖励,这些奖励可以在训练 sandbox 中模拟。
以 coding agent 为例。它们已经提高了软件工程的日常生产率,但许多优化目标仍然过于短期。Coding agent 通常可以完成眼前任务,却不清楚它应该如何保护一个由数百或数千名工程师共同维护的仓库的长期健康。标准的、基于 sandbox 的 RLVR 风格训练,很少能够捕获可维护性、所有权边界、迁移成本、向后兼容性或未来调试负担。
7. 人类的角色。 人类应该上移到更高层,而不是被移出循环。换句话说,人类应该在正确的时间、正确的抽象层级提供监督;系统设计也应该考虑何时、如何设置这样的接触点。
上面列出的许多挑战都需要人类反馈和引导。毕竟,我们是在为人类更美好的未来建设技术,而不是反过来。
引用方式
请按下面的格式引用本文原作:
Weng, Lilian. “Harness Engineering for Self-Improvement”. Lil’Log (Jul 2026). https://lilianweng.github.io/posts/2026-07-04-harness/
或者使用下面的 BibTeX:
@article{weng2026harness,
  title = {Harness Engineering for Self-Improvement},
  author = {Weng, Lilian},
  journal = {lilianweng.github.io},
  year = {2026},
  month = {July},
  url = "https://lilianweng.github.io/posts/2026-07-04-harness/"
}
附录:一些实用的 benchmark
- PaperBench:从零开始复现 20 篇 ICML 2024 Spotlight 和 Oral 论文,包括理解论文贡献、开发代码库并成功执行实验。
- 每项复现任务都会被拆成更小、可单独评分的任务。
- 共包含 8,316 条 rubric,由 benchmark 团队与论文作者共同制定。
- 当时表现最好的模型
Claude 3.5 Sonnet约为 21%,未能超过机器学习博士。 - 包含 PaperBench、较轻量的 PaperBench Code-Dev,以及 JudgeEval。
- CORE-Bench:评估已发表研究的计算可复现性。
- 基于计算机科学、社会科学和医学领域的 90 篇科学论文构造 270 项任务。
- 任务要求使用给定代码和数据复现结果。
- 包含多个难度等级,也同时包含纯语言和视觉语言任务。
- 当时报告的最佳智能体由
GPT-4o和GPT-4o-mini驱动,在最困难任务上的准确率只有 21%。
- ScienceAgentBench:评估 LLM 智能体进行数据驱动科学发现的能力。
- 从数学、化学、生物和地理四个学科的 44 篇同行评审论文中提取 102 项任务。
- 覆盖这些领域的基础数据科学任务,包括数据处理、模型开发、数据分析和信息可视化。
- RE-Bench:在真实的机器学习研究工程环境中,将前沿 AI 智能体与人类专家比较。
- 包含 7 个具有挑战性、开放式的机器学习研究工程环境。
- 每个环境由评分函数、起始解和参考解组成,可以使用不超过 8 块 H100 GPU 运行。
- 示例包括优化 kernel、运行 scaling law 实验、修复 embedding、为问答任务微调 GPT-2 等。
- 收集了 61 位不同人类专家完成的 71 次八小时尝试。
- 人类专家在 82% 的八小时尝试中取得非零分;其中 24% 达到或超过强参考解。
- 最好的 AI 智能体在两小时预算下得分是人类的 4 倍,但人类在更长预算下的收益更好,并在八小时和三十二小时设置中超过智能体。
- MLE-bench:在离线 Kaggle 竞赛上评估机器学习工程智能体。
- 包含从 Kaggle 筛选出的 75 项机器学习工程竞赛。
- 测试模型训练、数据集准备、实验运行,以及向评分脚本提交预测等能力。
- 使用 Kaggle 公开排行榜作为人类基线。
- 论文中表现最好的方案是
o1-preview配合 AIDE scaffold,在 16.9% 的竞赛中至少达到 Kaggle 铜牌水平。 - 包含资源扩展和数据污染分析。
- KernelBench:评估生成 GPU kernel 的正确性和速度。
- 包含 250 项 PyTorch 任务,用来评估 LLM 能否编写快速且正确的 kernel。
- 评估指标 fast_p 表示生成的 kernel 中正确且快于基线的百分比。
参考文献
- Good, I. J. “Speculations Concerning the First Ultraintelligent Machine.” Advances in Computers, 6:31–88, 1965.
- Yudkowsky, Eliezer. “Recursive Self-Improvement.” LessWrong, 2008.
- Choi, et al. “Anchored Self-Play for Code Repair.” ICML 2026.
- Zhao, et al. “Absolute Zero: Reinforced Self-play Reasoning with Zero Data.” arXiv preprint arXiv:2505.03335, 2025.
- Yuan, et al. “Self-Rewarding Language Models.” arXiv preprint arXiv:2401.10020, 2024.
- Chen, et al. “Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models.” ICML 2024.
- Zhang, et al. “Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models.” ICLR 2026.
- Ye, et al. “Meta Context Engineering via Agentic Skill Evolution.” arXiv preprint arXiv:2601.21557, 2026.
- Lee, et al. “Meta-Harness: End-to-End Optimization of Model Harnesses.” arXiv preprint arXiv:2603.28052, 2026.
- Lu, et al. “Towards end-to-end automation of AI research.” Nature, 651:914–919, 2026.
- Meng, et al. “ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence.” arXiv preprint arXiv:2605.26340, 2026.
- Kulikov, et al. “Autodata: An agentic data scientist to create high quality synthetic data.” arXiv preprint arXiv:2606.25996, 2026.
- Hu, Lu, and Clune. “Automated Design of Agentic Systems.” ICLR 2025.
- Madaan, et al. “Self-Refine: Iterative Refinement with Self-Feedback.” NeurIPS 2023.
- Zhang, et al. “AFlow: Automating Agentic Workflow Generation.” ICLR 2025.
- Zelikman, et al. “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation.” COLM 2024.
- Zhang, et al. “Self-Harness: Harnesses That Improve Themselves.” arXiv preprint arXiv:2606.09498, 2026.
- Fernando, et al. “Promptbreeder: Self-Referential Self-Improvement Via Prompt Evolution.” arXiv preprint arXiv:2309.16797, 2023.
- Agrawal, A. et al. “GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning.” arXiv preprint arXiv:2507.19457, 2025.
- Novikov, et al. “AlphaEvolve: A coding agent for scientific and algorithmic discovery.” arXiv preprint arXiv:2506.13131, 2025.
- Lange, Imajuku, and Cetin. “ShinkaEvolve: Towards Open-Ended And Sample-Efficient Program Evolution.” arXiv preprint arXiv:2509.19349, 2025.
- Wang, et al. “ThetaEvolve: Test-time Learning on Open Problems.” arXiv preprint arXiv:2511.23473, 2025.
- Zhang, et al. “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents.” arXiv preprint arXiv:2505.22954, 2025.
- Zhang, et al. “Hyperagents.” arXiv preprint arXiv:2603.19461, 2026.
- Yuksekgonul, et al. “Learning to Discover at Test Time.” arXiv preprint arXiv:2601.16175, 2026.
- Riaz, et al. “Epistemic Uncertainty for Test-Time Discovery.” arXiv preprint arXiv:2605.11328, 2026.
- Hebbar, et al. “SIA: Self Improving AI with Harness & Weight Updates.” arXiv preprint arXiv:2605.27276, 2026.
- Trehan and Chopra. “Why LLMs Aren’t Scientists Yet: Lessons from Four Autonomous Research Attempts.” arXiv preprint arXiv:2601.03315, 2026.
- Bubeck, et al. “Early science acceleration experiments with GPT-5.” arXiv preprint arXiv:2511.16072, 2025.
- Starace, et al. “PaperBench: Evaluating AI’s Ability to Replicate AI Research.” ICML 2025.
- Wijk, et al. “RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts.” ICML 2025.
- Chan, et al. “MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering.” arXiv preprint arXiv:2410.07095, 2024.
- Chen, et al. “ScienceAgentBench: Toward Rigorous Assessment of Language Agents for Data-Driven Scientific Discovery.” ICLR 2025.
- Siegel, et al. “CORE-Bench: Fostering the Credibility of Published Research Through a Computational Reproducibility Agent Benchmark.” TMLR 2024.
- Ouyang, et al. “KernelBench: Can LLMs Write Efficient GPU Kernels?” arXiv preprint arXiv:2502.10517, 2025.
- Lin, et al. “Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents.” arXiv preprint arXiv:2605.30621, 2026.
- Lin, et al. “Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses.” arXiv preprint arXiv:2604.25850, 2026.
- Karten, et al. “Continual Harness: Online Adaptation for Self-Improving Foundation Agents.” arXiv preprint arXiv:2605.09998, 2026.
- Che, et al. “DemoEvolve: Overcoming Sparse Feedback in Agentic Harness Evolution with Demonstrations.” arXiv preprint arXiv:2605.24539, 2026.
补充思考
以下为我的补充思考,不属于原文内容。
这篇文章最重要的贡献,不是又给 Agent 增加了一组组件名称,而是把“智能系统的能力”从模型权重扩展到了模型、运行时和外部环境共同构成的整体。用工程语言来说,模型负责提出动作,Harness 决定动作如何落地、状态如何保存、结果如何验证。部署后的能力因此不再等同于一次静态模型评测的分数。
1. 真正稀缺的不是候选方案,而是可信反馈
模型已经能够快速生成大量提示词、工作流和代码改动。自我改进的瓶颈随之转移:系统怎样确认某次提升来自正确机制,而不是测试泄漏、随机波动、预算增加或对评估器的迎合?Self-Harness 的 held-in/held-out 回归、AHE 的只读 verifier 与 evidence manifesto,本质上都在解决归因问题。
这也说明,评估器不应只是一个最终分数。更稳妥的验证体系应同时保留确定性测试、任务指标、轨迹审计和高风险节点的人类判断。候选生成器与最终裁决者若共享同一套可编辑状态,自我改进很容易退化成“修改评分规则”。
2. 文件系统的价值在于保留证据,而不只是扩展记忆
把信息移出上下文通常被解释为节省 token,但文件系统更关键的作用是保留可追溯的原始证据。摘要会压缩,条目会去重,工作上下文会被重写;实验日志、代码 diff、失败轨迹和 rejected candidate 却需要长期保留。发生矛盾或准备执行高风险动作时,系统必须能够回到原始记录,而不是继续引用多轮转述后的摘要。
因此,一个生产级 Harness 最好同时维护有限的 working context、结构化 task ledger 和 append-only 原始事件记录。摘要负责导航,原始事件负责证明。KV cache 能减少重复计算,但不能替代这套状态治理。
3. 可编辑边界决定了“自我改进”是否安全
允许智能体修改提示词、skill 或工具描述,和允许它关闭 verifier、替换模型、提高预算,不是同一级别的操作。前者是在既定规则内搜索策略,后者是在改变游戏规则。AHE 把运行目录、tracer、verifier 和模型配置设为只读,是全文中最值得落地的工程约束之一。
进一步说,调用次数、token、费用、墙钟时间、重试次数和副作用次数等预算,也应保存在模型无法重置的外部状态中。模型可以请求结束任务,但是否满足验收条件,应由独立验证逻辑根据真实制品决定。
4. Harness 优化具有明显的模型依赖
“Harness Updating Is Not Harness Benefit”提醒我们,写出一项看似合理的 Harness 修改,与真正利用这项修改完成长周期任务,是两种不同能力。强模型可能已经内化部分策略,因此额外 scaffold 的边际收益有限;中等模型可能获益最多;更弱模型则可能无法稳定调用新增 skill 或长期遵守约束。
因此,Harness 的效果不能脱离 base model、任务、工具集和预算单独报告。一个在某个模型上有效的复杂工作流,换到更强模型上可能只是额外负担,换到更弱模型上又可能成为无法执行的说明书。
5. 科研自我改进最终会撞上价值判断
代码测试、kernel 性能和调度成本拥有相对便宜的反馈,科学发现却没有预先给定的正确答案。即使代码可以运行,系统仍要判断问题是否重要、实验是否真正区分了假设、意外结果是否值得追踪,以及何时应该承认失败。这些判断混合了领域经验、研究品味和长期价值,暂时无法压缩成一个可靠的 judge score。
所以,人类在这条路线上的角色更可能上移,而不是消失。人类负责问题设定、证据标准、权限边界和方向判断;Harness 承担执行、记录、复核与恢复。自动化提高的是搜索和执行速度,可信科学仍依赖清楚的证据链与可追责的决策边界。
Recommended citation: Weng, Lilian. Harness Engineering for Self-Improvement. Lil’Log, July 2026.