StrSR 深读:DiT 单步超分为何出现网格伪影,频谱约束如何缓解它
Abstract:论文摘要解读
DiT 具有较强的图像生成能力,但多步采样带来推理开销。将它压缩为单步超分模型时,作者观察到两个相互关联的问题:预训练的噪声到图像轨迹,与超分需要的低质量图像到高质量图像映射不一致;一次大步更新又容易产生周期性纹理。
StrSR(arXiv v2) 用三组设计处理这些问题。首先,以 DiT 为生成器,以预训练 CLIP-ConvNeXt 特征和可训练判别头构成判别器,通过对抗训练适配输出分布。其次,引入已有的 Frequency Distribution Loss(FDL),约束预测图像与目标图像的特征频谱。最后,让 VAE 与 VLM 分别提供空间表示和语义条件,使生成器同时获得图像结构与内容线索。
作者将结果概括为 SOTA。实际阅读时应把这个表述拆开:FLUX 版本在主表的单步方法中具有较好的 LPIPS、DISTS 和部分无参考质量指标,但不存在所有骨干、所有数据集、所有指标全面领先的结果。
Motivation:为什么少采样几步会改变问题本身
起点变了,一步近似也不够准确
论文先回顾 Rectified Flow 的插值路径:
\[z_t=t z_1+(1-t)z_0,\]其中 $z_1$ 是噪声,$z_0$ 是高质量图像的 latent。预训练模型学习在这种中间状态上预测速度场。超分推理时,输入却变成了退化图像的编码 $z_{\mathrm{LR}}$。
作者指出两种差距:低质量 latent 不一定落在预训练过程相应时间的分布上;即使起点匹配,一次 Euler 更新也未必能准确到达目标分布。把 LR 直接视为某个中间时刻,并不能自动解决这两件事。
单步输出可以写成:
\[\hat z_0=z_{\mathrm{LR}}-t_1G_\theta(z_{\mathrm{LR}},t_1,c), \qquad \hat x=\mathcal D_{\mathrm{VAE}}(\hat z_0).\]这里 $G_\theta$ 预测的是速度,而不是直接输出 RGB。它必须通过任务适配,把 LR 到 HR 的映射压进一次更新。
一个需要补充的数学边界是:训练时为样本构造直线插值,不保证学到的边缘速度场在推理时处处具有直线轨迹。 因此,不能由 Rectified Flow 的名称推出“单步积分天然精确”。这是对论文预备知识段落的理解限定。
DiT 的重复纹理有可测量的空间周期
论文将周期性伪影与 patch 化表示联系起来:像素空间的伪影周期与 DiT patch 大小、VAE 缩放共同相关。作者进一步用频谱观察这些结构化误差,称其为高频 spectral leakage。
这里应区分观察与因果解释。重复图案在频域产生集中能量,是可以检查的现象;要证明所有网格伪影都由某个唯一机制导致,还需要更强的控制实验。StrSR 的补充材料确实给出 NFE 与网格频率的对照,但没有把解码器、训练数据和采样器等潜在影响全部排除。
直观效果:FDL 改变了哪些细节
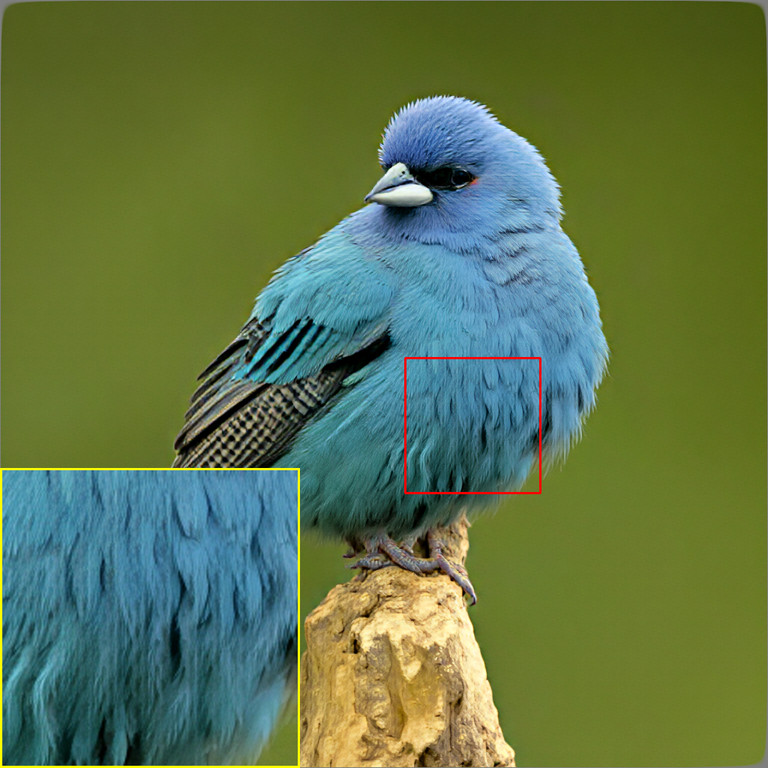
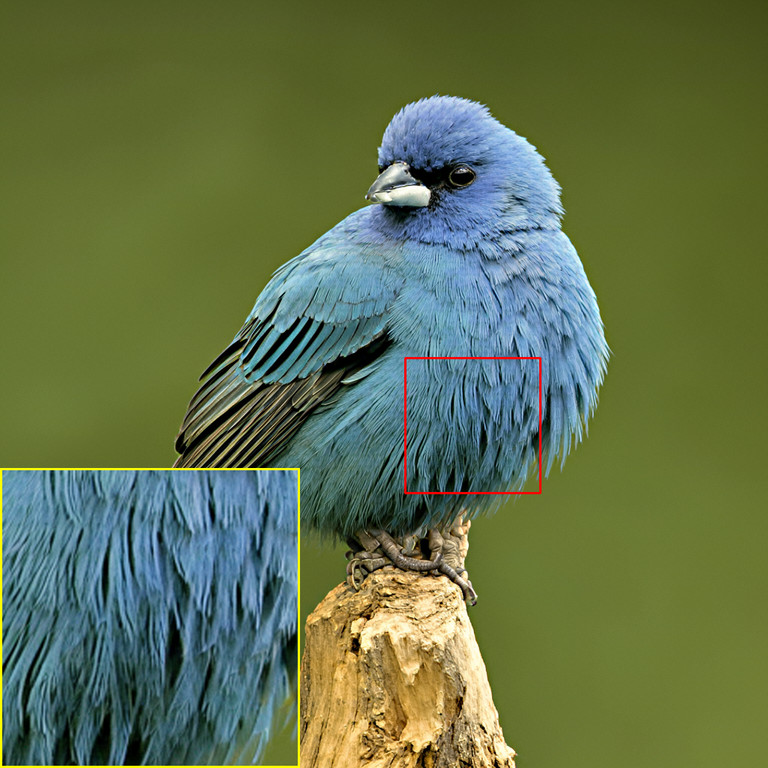
图:原论文 FDL 消融图的两幅完整图像,来自 TeX 中 fig:vis-ablation 左侧。观察胸前放大区域,纹理的重复方式、线条清晰度发生变化。这组示例没有同时给出 GT,因而适合说明外观差异,不能单独证明细节更忠实。点击可查看原尺寸。
这组结果也说明,频谱约束并不等于简单低通滤波。作者希望减少的是不自然的周期性误差,同时保留细粒度纹理。判断它是否成功,要同时看伪影、真实纹理和与 GT 的对应关系,不能只比较谁更锐。
方法总览:各个模块分别负责什么
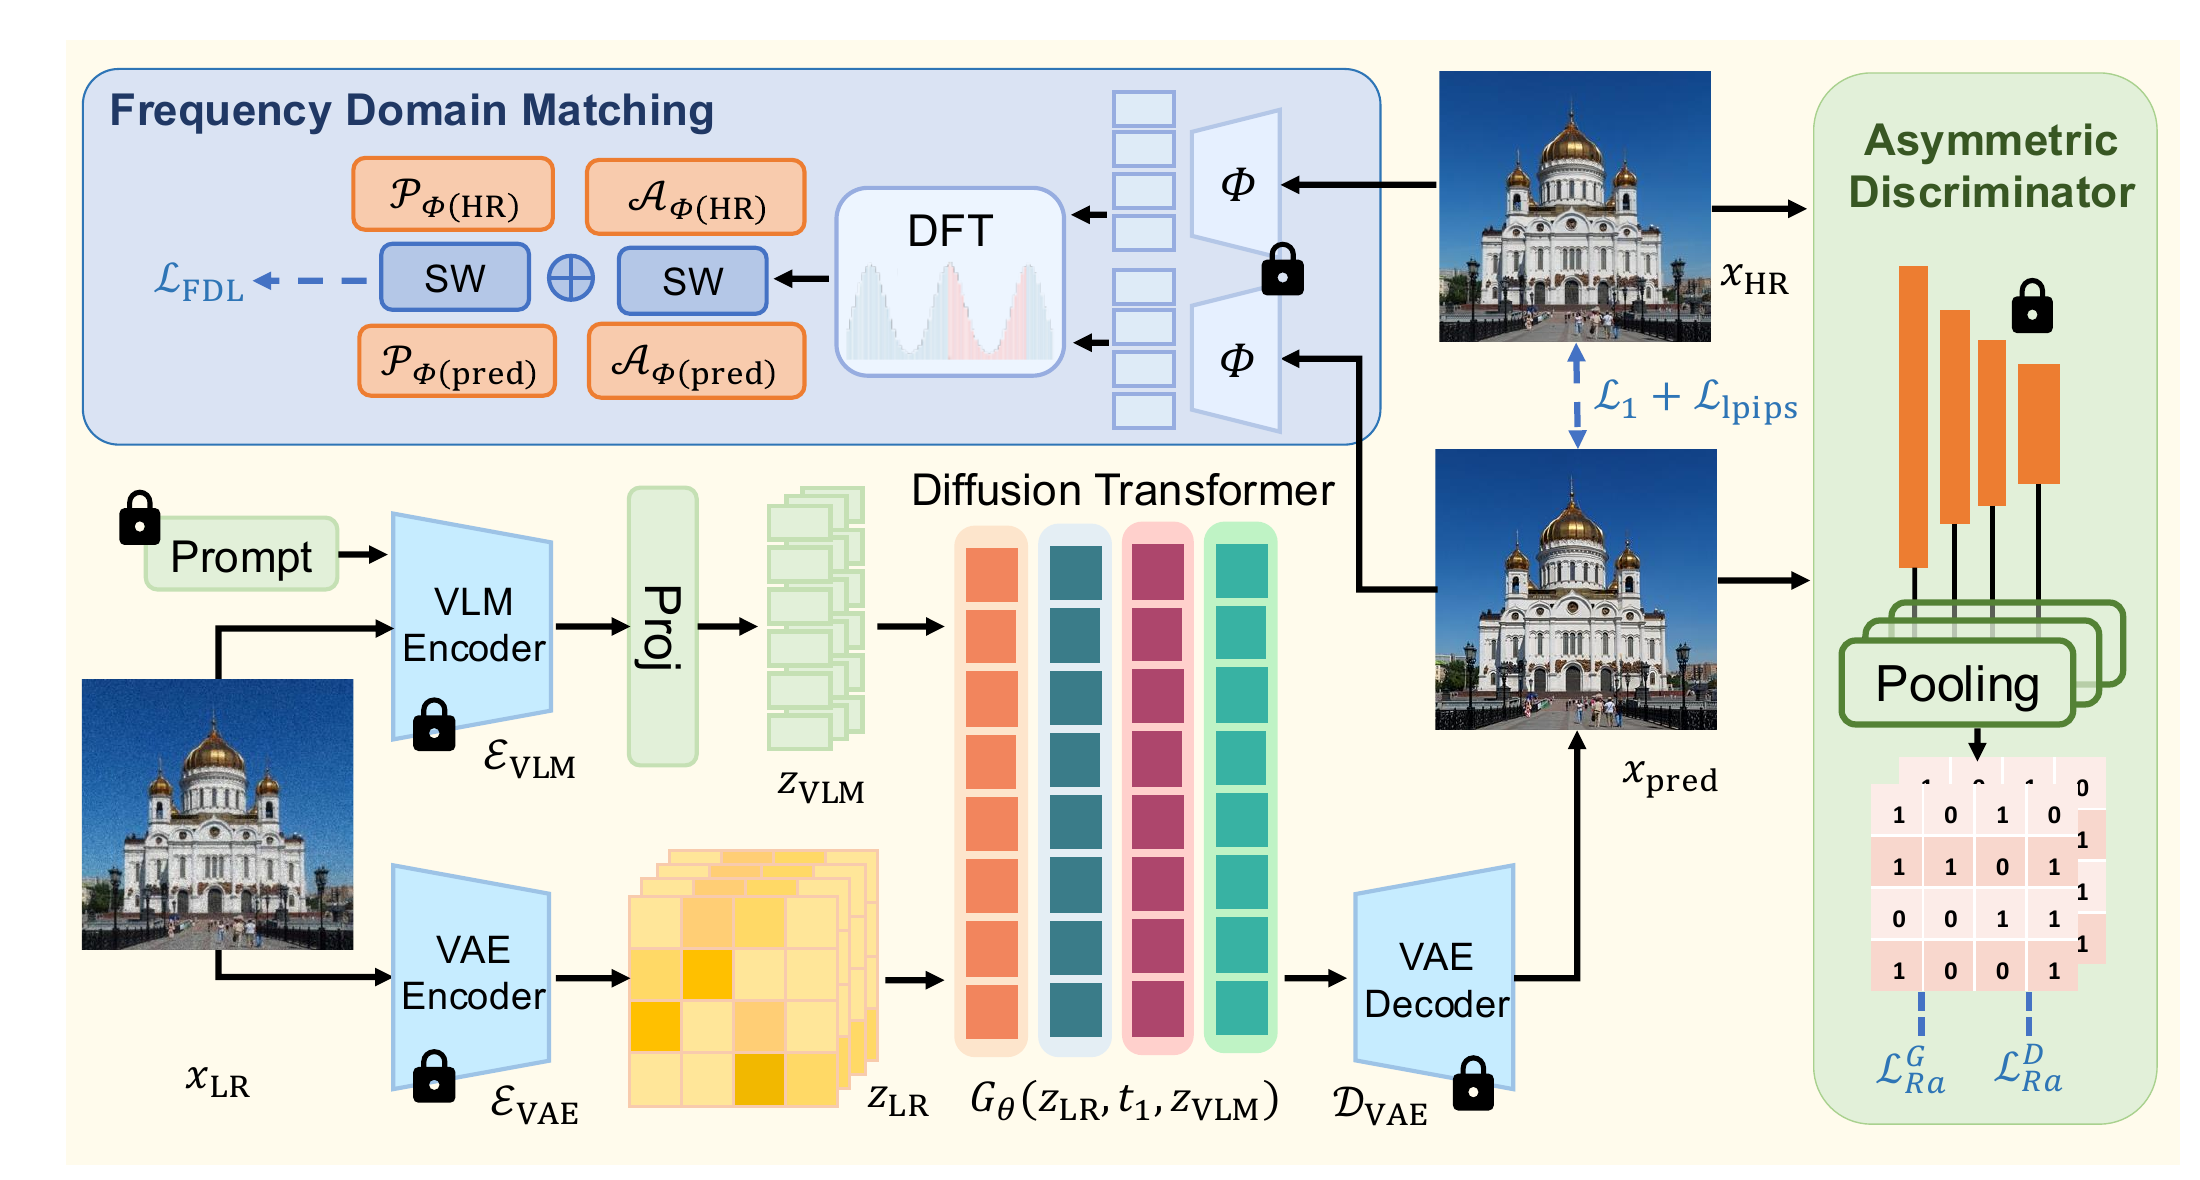
图:原论文训练框架 fig:overall(作者原文,CC BY 4.0),由官方 TeX 中 figs/pdf/overall.pdf 渲染。下方是生成路径,上方和右侧是训练约束。锁表示冻结的预训练模块;判别器仍有可训练头。图中没有展开单步 latent 更新,需结合上一节公式理解。
| 模块 | 输入与输出 | 解决的问题 |
|---|---|---|
| VAE | 图像 → 空间 latent;最终 latent → RGB | 保留用于复原的空间结构,并连接像素空间与 DiT |
| VLM + MLP | LR 图像及固定指令 → 语义条件序列 | 为纹理类别和物体语义提供线索 |
| DiT + LoRA | LR latent、时间、语义条件 → 速度预测 | 学习单步 LR → HR 映射 |
| CLIP-ConvNeXt 判别器 | 预测 / HR 图像 → 多层局部及全局 logits | 让输出具备自然图像的纹理统计 |
| FDL 特征分支 | 预测 / HR 图像 → 特征频谱分布距离 | 抑制异常周期性结构 |
VLM 条件不是必须先生成一段 caption
论文把 VLM 输出经 MLP 投影后,直接替代原有文本条件。当前 FLUX 训练源码进一步揭示:Qwen3-VL 接收 LR 图像和固定图像描述指令,读取最后一层 hidden states,排除图像 token 位置,再把剩余 token 的表示投影给 DiT。它没有先自回归生成完整描述,再将描述重新编码。
这些虽然是非图像 token 位置的 hidden states,却已经经过多模态上下文处理,可以携带图像信息。MLP 的输入宽度取自 Qwen 配置,输出宽度取自 DiT 的 joint_attention_dim,不能把代码里的 fallback 数字当成实际权重的维度。
“非对称”指生成器与判别器的结构不同
作者报告,用 DiT 同时构造生成器和判别器时会出现快速训练崩溃。因此采用卷积式 CLIP-ConvNeXt 提取多尺度特征,并用多个可训练头判别局部纹理与全局表示。
论文认为卷积的局部归纳偏置更适合检查周期性纹理。源码确认 CLIP 特征骨干被冻结,训练的是判别头。这个设计减少了可训练判别器部分的负担,但 CLIP-ConvNeXt-XXLarge 本身仍不是可以忽略的训练成本。
标题中的 trajectory regularization 也不应读成一个显式的轨迹曲率损失。最终目标主要通过重建、感知和对抗损失适配单步映射;没有要求学生逐点拟合一条多步教师轨迹。
数据全流程:训练与测试分别流过什么
下面用 batch size $B$、目标图像尺寸 $H\times W$ 和语义序列长度 $L$ 表示。通道数取决于具体骨干;论文未统一给出完整张量规格。
| 阶段 | 数据 / Shape | 含义及来源 |
|---|---|---|
| 训练 HR | RGB,$B\times3\times1024\times1024$ | 论文使用中心裁剪的高质量图像 |
| 合成 LR | RealESRGAN 退化输出 | 模拟模糊、缩放、噪声、JPEG 等;当前配置再 resize 回目标尺寸供 VAE 使用 |
| VAE 输入 | $B\times3\times H\times W$,归一化至 $[-1,1]$ | 当前 FLUX 路径使用目标尺寸的低质量图像 |
| 空间表示 | $B\times C_z\times H_z\times W_z$,随后 patchify / pack | 表示复原的起点;具体 $C_z,H_z,W_z$ 应由实际 VAE 配置与 packing 确认 |
| VLM 输入 | LR RGB,另经 Qwen processor 处理 | 当前训练使用 low_LQ;与 VAE 的输入分辨率路径不同 |
| 语义表示 | $B\times L\times d_{\mathrm{cond}}$ | FLUX 代码默认最多保留 512 个非图像 token,MLP 投影后按 batch padding |
| DiT 输出 | 与 packed latent 对应的速度序列 | 单次前向后积分、unpack、反归一化与解码 |
| 最终输出 | $B\times3\times H\times W$ | 训练时与 HR 比较;测试时不需要 HR |
表中的张量记号用于解释数据结构,并非论文报告了所有维度。尤其不能照搬 FLUX.1 的 latent 参数到 FLUX.2。代码中 VLM hidden size 与条件宽度均动态读取,本文没有加载权重配置来进一步核验它们。
还有一处实现差别:论文把 LR latent 表述为确定性起点,当前训练与推理源码却调用 latent_dist.sample()。这不等于从纯高斯噪声生成图像,但意味着逐次输出的可重复性还受 VAE posterior sampling 和随机种子影响。
Training:用什么约束单步输出
空间约束:内容对应与输出真实性
生成器的论文目标为:
\[\mathcal L_G=\mathcal L_1+\lambda_1\mathcal L_{\mathrm{LPIPS}} +\lambda_2\mathcal L_{\mathrm{Ra}}^G +\lambda_3\mathcal L_{\mathrm{FDL}}.\]L1 维持预测与 GT 的像素对应;LPIPS 提供特征空间的感知约束;GAN 鼓励自然图像外观。三者共同决定感知与失真的折中,任何一个都不能独立保证细节真实。
RaGAN 的关键是相对比较。设 $C$ 为判别器 logit,则:
\[g(x,y)=\operatorname{sigmoid}\left(C(x)-\mathbb E_y[C(y)]\right).\]它衡量当前样本相对于另一组样本的真实性。判别器推动真实样本高于生成样本,生成器推动相反方向。论文消融支持 RaGAN 在所测无参考指标上优于普通 non-saturating GAN,但这并不构成对任意数据和骨干都更稳定的保证。
判别器还使用加噪一致性形式的近似 R1:
\[\mathcal L_{\mathrm{R1}}=\mathbb E_{x,\epsilon} \left\|D(x)-D(x+\epsilon)\right\|_2^2.\]小幅高斯扰动前后保持判别输出相近,以限制过敏感的判别边界。它不是直接计算标准 R1 的输入梯度范数。论文设置扰动尺度为 0.005,R1 权重为 10。
频谱约束:比较特征的振幅和相位分布
FDL 先用预训练特征提取器 $\Phi$ 处理预测与 GT,再对特征做 DFT。令 $\mathcal A$、$\mathcal P$ 分别为振幅和相位:
\[\begin{aligned} \mathcal L_{\mathrm{FDL}}={}& \operatorname{SW}\left(\mathcal A_{\Phi(x_{\mathrm{HR}})}, \mathcal A_{\Phi(\hat x)}\right)\\ &+\lambda\operatorname{SW}\left(\mathcal P_{\Phi(x_{\mathrm{HR}})}, \mathcal P_{\Phi(\hat x)}\right). \end{aligned}\]SW 是 Sliced Wasserstein 距离,通过投影后的分布比较衡量差异。直观上,振幅反映不同频率成分的强弱,相位与结构的位置关系相关。FDL 约束的是这些特征频率成分的分布,并非要求每个 RGB 像素的 FFT 系数严格逐点相等。
FDL 不是 StrSR 首次提出的损失。 论文明确引用 Ni 等人在 CVPR 2024 的 Misalignment-robust frequency distribution loss for image transformation。StrSR 的贡献应表述为将其用于 DiT 单步超分的周期性伪影,并与对抗适配、训练阶段安排结合。当前代码通过 FDL_pytorch.FDL_loss() 调用外部实现;特征提取器、投影数量和内部相位权重等默认值需要继续锁定依赖源码,本文不补造这些参数。
为什么 FDL 在第二阶段才加入
图:依据正文训练设置和补充材料两阶段消融重绘。训练先进行 40k 步任务适配,再用 20k 步加入 FDL;下方列出测试时保留的模块。
| 配置 | 论文报告 |
|---|---|
| 第一阶段 | 40,000 steps;L1 = 1、LPIPS = 3、GAN = 0.1、FDL = 0 |
| 第二阶段 | 再训练 20,000 steps;FDL 权重改为 0.002 |
| 更新方式 | 生成器 / 判别器 1:1 交替更新 |
| 可训练生成部分 | DiT LoRA,rank = 256;语义投影层 |
| LoRA alpha | 补充材料给出 256 |
| 优化器 | AdamW;生成器学习率 $5\times10^{-6}$,判别器 $10^{-6}$ |
| 资源 | 4 张 NVIDIA A800,bf16;正文 batch size = 4 |
补充材料比较了训练早期就加入 FDL 的损失曲线。作者报告它会干扰 GAN 和感知损失的优化,引发不稳定。因此先学习 LR 到 HR 的适配,再对频谱细化。这提供了阶段顺序的实验依据,但没有证明 40k / 20k 是最优分配,也没有充分扫描 FDL 权重与启用时机。
Inference:单步之外仍有哪些计算
按当前 FLUX 推理源码,处理顺序为:
- 将输入按放大倍率做 Bicubic 上采样,作为目标尺寸的 VAE 输入;原始 LR 提供 Qwen 条件。
- Qwen3-VL 与投影层生成条件表示,VAE 编码图像并完成 latent 变换。
- DiT 前向一次,按指定时间系数更新 latent。
- 解码回 RGB;大图可以分块运行,重叠区域加权融合,再恢复目标尺寸。
公开 FLUX 第二阶段配置设定 model_t = 800、coeff_t = 800,代码分别归一化到 0.8,用于模型时间输入与积分系数。论文正文未明确给出这两个值,因此它们属于代码证据。
NFE = 1 说的是每次单步生成中的 DiT 求值次数。VLM、VAE 编解码仍需计算;若整图切成多块,DiT 会对每块求值。FDL 和判别器不进入推理。
论文速度图报告,RTX A6000 上 StrSR-F 为 1.052 s、StrSR-Z 为 1.591 s,HYPIR 为 1.054 s,TSD-SR 为 0.894 s。作者将其描述为 1024×1024 图像的 ×4 超分计时,但正文没有充分拆明 VLM、预处理与分块是否计入,输入 / 输出尺寸口径也应在复现时确认。这些数字不能直接作为某张任意大图的端到端承诺。官方 README 的推理要求为显存至少 40 GB,“单步”也不意味着适合端侧。
Evaluation:三类数据和三类证据
论文训练使用完整 LSDIR 与 Aesthetic-4K 的前 60,000 张图像,裁剪到 1024×1024,并用 RealESRGAN 管线合成 LR。测试均为 ×4:DIV2K-val 使用合成退化;RealSR 使用真实配对数据;RealLQ250 为真实低质量数据,其主表只列无参考指标。
所有指标通过 pyiqa 计算,但它们回答的问题不同。
| 指标 | 能支持的判断 | 不能直接推出的结论 |
|---|---|---|
| PSNR / SSIM | 与 GT 的像素 / 结构相近程度 | 高分必然有自然、丰富的细节 |
| LPIPS / DISTS | 与 GT 的感知特征 / 纹理结构距离 | 所有局部语义和细节均正确 |
| NIQE、MANIQA、MUSIQ、QAlign、QualiCLIP | 图像质量模型偏好的外观 | 生成内容忠于输入或历史真实场景 |
下面数字均为作者报告,本文没有重新运行测试。完整版表格、颜色空间、裁边规则及测试预处理应以论文和对应评测实现为准,不能仅由 pyiqa 名称推定完全相同的协议。
实验与证据:主张具体成立在哪里
FLUX 版本的感知指标较强,像素精度存在折中
| 数据集 / 方法 | PSNR ↑ | LPIPS ↓ | DISTS ↓ | MANIQA ↑ |
|---|---|---|---|---|
| DIV2K-val / PiSA-SR | 23.36 | 0.3442 | 0.1789 | 0.5706 |
| DIV2K-val / HYPIR | 21.78 | 0.3551 | 0.1457 | 0.5673 |
| DIV2K-val / StrSR-F | 21.70 | 0.2992 | 0.1288 | 0.5864 |
| RealSR / PiSA-SR | 25.60 | 0.2744 | 0.1745 | 0.6277 |
| RealSR / StrSR-Z | 22.15 | 0.3215 | 0.1958 | 0.5941 |
| RealSR / StrSR-F | 23.77 | 0.2599 | 0.1665 | 0.6333 |
来源:正文 DIV2K-val 与 RealSR 主表,以上为选取的比较行。粗体仅比较本表同数据集行。
StrSR-F 相比 PiSA-SR,在 RealSR 上的 LPIPS 从 0.2744 降到 0.2599,同时 PSNR 从 25.60 降到 23.77。这是感知质量与失真的不同取舍。Z-Image 版本在这个数据集的 LPIPS、DISTS 又都落后于 PiSA-SR,所以“两个版本均优于所有单步方法”不是主表支持的精确表述。
补充材料还列出 SwinIR:RealSR 的 LPIPS = 0.2593、DISTS = 0.1609,均略好于 StrSR-F。这进一步限定了领先范围:主表中的单步扩散方法集合,不等于全部超分方法。
RealLQ250 上,StrSR-F 的 NIQE = 3.4693、MANIQA = 0.6138、QAlign = 4.2851,在列出的单步方法中最好;MUSIQ = 69.2050 则低于 TSD-SR 的 71.0490。无参考结果说明外观竞争力,不能证明没有幻觉。
同骨干 HYPIR 对照:方法收益与基础模型收益要拆开
补充材料把 HYPIR 迁移到 FLUX,并声明使用相同训练数据、训练步数与 LoRA rank / alpha。这个对照比直接跨骨干排名更有解释力。
| DIV2K-val | LPIPS ↓ | DISTS ↓ | NIQE ↓ | MANIQA ↑ |
|---|---|---|---|---|
| HYPIR-FLUX | 0.2966 | 0.1318 | 3.5287 | 0.5533 |
| StrSR-FLUX | 0.2992 | 0.1288 | 3.0379 | 0.5864 |
StrSR 的 DISTS 和几项无参考指标更好,LPIPS 则略差。可支持的结论是:训练方案在相同基础模型上改善了部分质量维度。它还不足以证明每个模块都独立有效,因为这个对照没有逐一隔离所有改动。
GAN 和 VLM 消融支持外观收益,缺少同等强度的忠实性证据
| 正文消融 / DIV2K-val | MANIQA ↑ | MUSIQ ↑ | QAlign ↑ |
|---|---|---|---|
| 无 GAN | 0.4720 | 54.086 | 4.1629 |
| 普通 GAN,替代 RaGAN | 0.4930 | 61.820 | 4.4570 |
| 无条件 embedding | 0.5043 | 58.868 | 4.1291 |
| 普通文本编码,替代 VLM | 0.5300 | 62.093 | 4.3435 |
| 完整设置 | 0.5754 | 65.106 | 4.4779 |
补充材料将正文这组消融说明为 Z-Image 设置,并另列 FLUX 消融。这些消融数值与最终主表并不完全相同,不能拼接成一条未经说明的性能递增链。
从数据看,GAN、相对损失和 VLM 都对质量评分有贡献。不过,这张表没有同步报告 PSNR、LPIPS、文字识别或其他语义正确性指标。因此它对“生成更像自然图像”的支撑,强于对“恢复了输入中正确细节”的支撑。
网格频率分析比“看起来有伪影”更进一步
补充材料定义 GFLR:对预测与 HR 的残差做傅里叶变换,比较网格频率附近和其余背景的平均功率,再取对数。它专门测量误差是否集中在 patch-grid 相关频率。
| NFE | 10 × GFLR,网格周期 T = 16 ↓ | 10 × GFLR,对照周期 T = 11 ↓ |
|---|---|---|
| 1 | 9.28 ± 0.26 | 5.90 ± 0.36 |
| 2 | 8.59 ± 0.28 | 5.82 ± 0.36 |
| 4 | 8.70 ± 0.28 | 5.78 ± 0.36 |
| 8 | 8.73 ± 0.27 | 5.78 ± 0.36 |
来源:补充材料 GFLR 表;保留原表的 10 倍缩放。该段未充分说明 ± 的统计含义,不能自行称为置信区间。
结果支持:单步误差在网格频率处更集中,多步有所缓解。但从 2 到 8 步并不单调下降;这不是“步数越多伪影越少”的完整曲线。该表比较的是 NFE,也不是 FDL 的独立定量消融。FDL 的证据主要来自频谱、末层特征和视觉对照;若补上有无 FDL 的 GFLR、配对保真指标与多种子的比较,因果链会更完整。
补充材料对 SeedVR2 的比较来自其 Hugging Face Space,主要展示选定图像的外观差异,缺少同配置定量对照。它可作为案例观察,不能推出 StrSR 普遍优于 SeedVR2。
总结
StrSR 提供了一条具体的研究思路:当单步生成出现稳定的结构化错误时,可以先将错误转成可测量的频率现象,再安排与任务适配相协调的训练约束。双编码器、卷积判别器和后期 FDL 共同构成了这套方案。
它的适用方向是重视自然观感的真实照片超分,尤其是容易出现重复高频纹理的场景。对于文字、精确图案和必须忠于观测的复原需求,还需要额外证据。作者也明确承认像素保真、文字区域和大模型部署成本的局限。
这项工作的启发在于问题诊断与对照设计:看具体失败模式,测对应频率,做同骨干比较,并分别检查外观与保真。FDL 是已有方法,预训练底座贡献也很大;将这些边界说清楚,才能准确理解 StrSR 新增了什么,以及下一步还需要验证什么。